本文介绍了 RNN (循环神经网络)的基本概念,以及正/反向传播的推导过程。最后分析了 RNN 的梯度消失和梯度爆炸问题。
1. RNN
1.1. 概念
在前馈神经网络中,信息传递是单向的[1]。前馈神经网络可以看作一个复杂的函数,每次输入都是独立的,即网络的输出只依赖于当前的输入.但是在很多现实任务中,网络的输出不仅和当前时刻的输入相关,也和其过去一段时间的输出相关。此外,前馈网络难以处理时序数据,比如视频、语音、文本等.时序数据的长度一般是不固定的,而前馈神经网络要求输入和输出的维数都是固定的,不能任意改变.因此,当处理这一类和时序数据相关的问题时,就需要一种能力更强的模型.
循环神经网络(Recurrent Neural Network,RNN)是一类具有短期记忆能力的神经网络.在循环神经网络中,神经元不但可以接受其他神经元的信息,也可以接受自身的信息,形成具有环路的网络结构.和前馈神经网络相比,循环神经网络更加符合生物神经网络的结构.循环神经网络已经被广泛应用在语音识别、语言模型以及自然语言生成等任务上。
RNN 用于分类的简单例子参考:
根据人名判断国家:字符级 RNN 对单词分类。输入人名单词,将每个字符进行编码后读取(one-hot),在每一步输出预测和“隐藏状态”,将其先前的隐藏状态输入至下一时刻。将最终时刻输出作为预测结果,即表示该词属于哪个类(哪个国家的人名)。
根据句子判断语言:单词级 RNN 对句子分类。输入一个句子,将每个单词进行编码后读取(word2vec),在每一步输出预测和“隐藏状态”,将其先前的隐藏状态输入至下一时刻。将最终时刻输出作为预测结果,即表示该词属于哪个类(哪个国家的语言)。
上述例子中,输入是对 字符 / 单词 序列的编码,编码方式可以是 one-hot 形式也可以采用 word2vec 方法。期望输出一般是一个 one-hot 向量,比如 10 种国家 / 语言,预测输出一般是一个多分类概率结果。
1.2. 模型
循环神经网络(Recurrent Neural Network,RNN)通过使用带自反馈的神经元,能够处理任意长度的时序数据。
给定一个输入序列 $\boldsymbol x_{1:T} = (\boldsymbol x_1,…,\boldsymbol x_t,…,\boldsymbol x_T)$,通过下面的公式更新隐层活性值 $\boldsymbol h_t$:
\[\boldsymbol h_t = f(\boldsymbol h_{t-1},\boldsymbol x_t)\]其中,$\boldsymbol h_0 = 0$,$f(\cdot)$ 是非线性函数,可以是一个前馈网络。
网络结构如下图所示
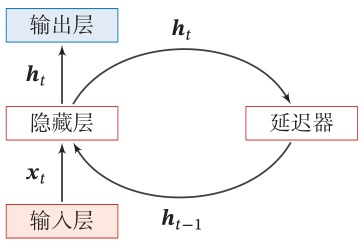
从数学上讲,上述公式可以堪称一个动力系统,因此隐层活性值在很多文献中也称为隐状态(hidden state)。
由于循环神经网络具有短期记忆能力,因此其计算能力十分强大,可以近似任意非线性动力系统(程序),相比较而言,前馈神经网络可以模拟任何连续函数。
1.3. 前向传播
如果我们把每个时刻的状态都看作前馈神经网络的一层,循环神经网络可以看作在时间维度上权值共享的神经网络。一个简单的循环神经网络按时间展开后如下图所示
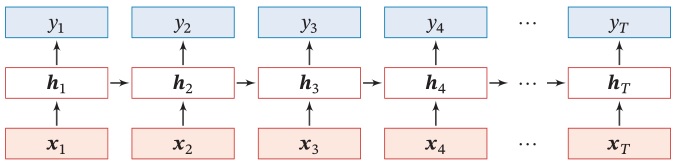
令 $\boldsymbol x_t \in \mathbb R^M$ 为 $t$ 时刻的网络输入向量,则在该时刻的网络隐状态 $\boldsymbol h_t \in \mathbb R^D$ 和网络输出 $\boldsymbol y_t \in \mathbb R^N$ 的更新公式为
\[\begin{aligned} \boldsymbol h_t &= f(\boldsymbol U \boldsymbol h_{t-1} + \boldsymbol W \boldsymbol x_t + \boldsymbol b)\\ \boldsymbol y_t &= g(\boldsymbol V \boldsymbol h_t + \boldsymbol c) \end{aligned}\]其中 $\boldsymbol U \in \mathbb R^{D\times D}$ 是状态-状态权重矩阵,$\boldsymbol W \in \mathbb R^{D\times M}$ 是状态-输入权重矩阵,$\boldsymbol b \in \mathbb R^D, \boldsymbol c \in \mathbb R^N$ 是偏置向量,$\boldsymbol V \in \mathbb R^{N\times D}$ 是状态-输出权重矩阵,$f(\cdot)$ 是激活函数,如 $sigmoid$ 或 $tanh$ 函数,$g(\cdot)$ 也是激活函数,如 $softmax$ 或 $purlin$ 函数。
注意到,第二个方程的具体形式与模型的具体使用方式有关,比如其中的常数项 $\boldsymbol c$ 的有无,激活函数 $g(\cdot)$ 的选取等。
1.4. 反向传播
有了RNN前向传播算法的基础,就容易推导出RNN反向传播算法的流程了。RNN 反向传播算法的思路和 DNN 是一样的,即通过梯度下降法一轮轮的迭代,得到合适的RNN模型参数 $\boldsymbol U,\boldsymbol W,\boldsymbol V,\boldsymbol b,\boldsymbol c$。由于我们是基于时间反向传播,所以 RNN 的反向传播有时也叫做 BPTT (back-propagation through time)。当然这里的 BPTT 和 DNN 的 BP 也有很大的不同点,即这里所有的 $\boldsymbol U, \boldsymbol W,\boldsymbol V,\boldsymbol b,\boldsymbol c$ 在序列的各个位置是共享的,反向传播时我们更新的是相同的参数。
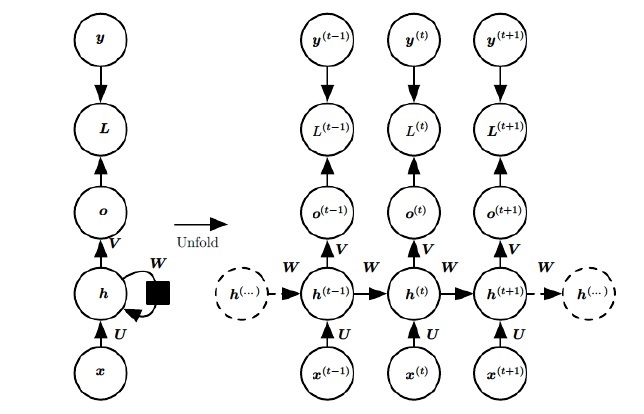
RNN反向传播过程中,需要计算 $\boldsymbol U,\boldsymbol W,\boldsymbol V,\boldsymbol b,\boldsymbol c$ 等参数的梯度。清晰起见,我们将前向传播过程整理如下
\[\begin{aligned} \boldsymbol a_t &= \boldsymbol W \boldsymbol h_{t-1} + \boldsymbol U \boldsymbol x_t + \boldsymbol b\\ \boldsymbol h_t &= f(\boldsymbol a_t)\\ \boldsymbol o_t &= \boldsymbol V \boldsymbol h_t + \boldsymbol c\\ \hat{\boldsymbol y_t} &= g(\boldsymbol o_t) \end{aligned}\]反向传播的形象的分析如下图所示。途中绿线是正向传播过程,红线是反向传播过程。可以看出,在输出端的 $V,c$ 参数仅与 $t$ 时刻的反向传播通路有关,因此分别求导数后求和即可。而输入端 $U,W,b$ 参数的梯度受到两个反向传播通路的影响,分别是 $t$ 时刻的输出端反向通路,以及 $t+1$ 时刻隐层信息的反向通路。
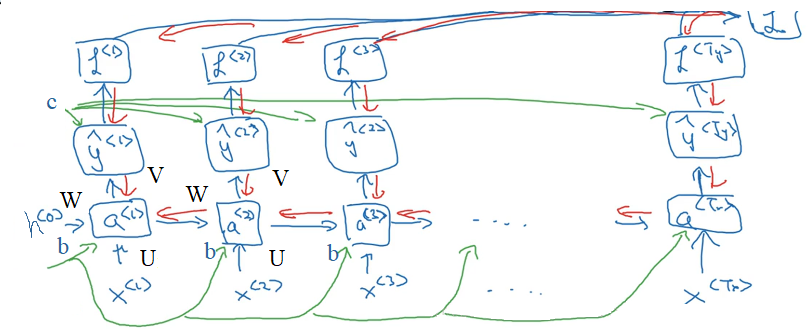
不妨假设这里使用 RNN 执行分类任务,损失函数采用 交叉熵损失函数,输出的激活函数 $g(\cdot)$ 为 softmax 函数。
分类任务下的 RNN 有两种形式:
- many-to-one:输入序列 $\boldsymbol x_1,…,\boldsymbol x_T$ 映射为单个向量(软阈值) $\hat{\boldsymbol y}$
- 即用于序列分类任务,比如:
- 文本情感分类:给定一段文本,预测其正面/负面/中性
- 时序信号分类:给定一段时间序列信号,预测其为正常/故障
- 此时只考虑最终时刻的损失函数 \(L = -\boldsymbol y_t \log \hat{\boldsymbol y}_t\)
- 即用于序列分类任务,比如:
- many-to-many: 输入序列 $\boldsymbol x_1,…,\boldsymbol x_T$ 映射为输出序列 $\hat{\boldsymbol y}_1,…,\hat{\boldsymbol y}_T$
- 即用于逐时刻分类任务:
- 命名实体识别(NER):给定一段文本,识别出其中的实体(BIO标签)
- 词性标注(POS):给定一段文本,识别出其中的词性(名词、动词、形容词)
- 损失函数每个时刻都有: \(L = \sum_{t=1}^T -\boldsymbol y_t \log \hat{\boldsymbol y}_t\)
- 即用于逐时刻分类任务:
以 many-to-many 为例。首先计算比较简单的 $V,c$ 的梯度。在输出端的 $V,c$ 参数仅与 $t$ 时刻输出侧的反向传播通路有关。首先定义:
\[\nabla_{\boldsymbol o_t} L =\frac{\partial L_t}{\partial \hat {\boldsymbol y_t}} \frac{\partial \hat {\boldsymbol y_t}}{\partial \boldsymbol o_t} = \frac{\partial L}{\partial\hat{\boldsymbol y}_t}\,g'(\boldsymbol o_t)\]softmax + 交叉熵特例:$\nabla_{\boldsymbol o_t} L=\hat{\boldsymbol y}_t-\boldsymbol y_t$
那么对 $\boldsymbol V, \boldsymbol{c}$ 的偏导为
\[\begin{aligned} \frac{\partial L}{\partial \boldsymbol{V}} &= \sum_{t=1}^T \frac{\partial L_t}{\partial \boldsymbol{V}} = \sum_{t=1}^T \frac{\partial L_t}{\partial \hat {\boldsymbol y_t}} \frac{\partial \hat {\boldsymbol y_t}}{\partial \boldsymbol o_t} \frac{\partial \boldsymbol o_t}{\partial \boldsymbol V}= \sum_{t=1}^T \nabla_{\boldsymbol o_t} L\boldsymbol h_t^\top\\ \frac{\partial L}{\partial \boldsymbol{c}} &= \sum_{t=1}^T \nabla_{\boldsymbol o_t} L \end{aligned}\]$\boldsymbol U,\boldsymbol W,\boldsymbol b$ 的梯度计算就比较复杂了,误差传播源来自于两个反向传播通路的方向,分别是 $t$ 时刻的输出端反向通路,以及 $t+1$ 时刻隐层信息的反向通路。核心在于写出损失函数关于两个反向通路的共用节点 $\boldsymbol{h}_t$ 的偏导数。
对于最终时刻 $T$:
\[\nabla_{\boldsymbol{h}_T} L = \boldsymbol{V}^\top\nabla_{o_T} L\]对于 $T$ 时刻之前的任意时刻 $t$,根据迭代关系,$\boldsymbol h_t$ 与 $\boldsymbol o_t$ 和 $\boldsymbol h_{t+1}$ 均有关,即
\[\boldsymbol h_{t+1} = f(\boldsymbol a_{t+1}) =f(\boldsymbol W \boldsymbol h_t + \boldsymbol U \boldsymbol x_{t+1} + \boldsymbol b)\]对两个反向通路方向的梯度求和,有
\[\begin{aligned} \frac{\partial L}{\partial \boldsymbol h_t}&=\frac{\partial L}{\partial \boldsymbol h_{t+1}}\frac{\partial \boldsymbol h_{t+1}}{\partial \boldsymbol h_t} + \frac{\partial L}{\partial \boldsymbol o_t}\frac{\partial \boldsymbol o_t}{\partial \boldsymbol h_t}\\ &=\frac{\partial \boldsymbol L}{\partial \boldsymbol h_{t+1}}\frac{\partial \boldsymbol h_{t+1}}{\partial \boldsymbol a_{t+1}}\frac{\partial \boldsymbol a_{t+1}}{\partial \boldsymbol h_t} + \boldsymbol V^T\nabla_{\boldsymbol o_t} L \end{aligned}\]下面考察 $\partial \boldsymbol h_t / \partial \boldsymbol a_t$,因为 $\boldsymbol h_t, \boldsymbol a_t$ 均为列向量,若采用分母布局,将分子 $\boldsymbol h_t$ 看作行向量展开,那么
\[\begin{aligned} \frac{\partial \boldsymbol h_t }{ \partial \boldsymbol a_t} &= \partial[h_1,h_2,\cdots,h_D]/\partial \boldsymbol a_t\quad<row!>\\ &=\begin{bmatrix} \partial h_1/\partial a_1&\partial h_2/\partial a_1&\cdots&\partial h_D/\partial a_1\\ \partial h_1/\partial a_2&\partial h_2/\partial a_2&\cdots&\partial h_D/\partial a_2\\ \vdots&\vdots&\ddots&\vdots\\ \partial h_1/\partial a_D&\partial h_2/\partial a_D&\cdots&\partial h_D/\partial a_D\\ \end{bmatrix}\\ &= \text{diag}(f'(a_{t})) \end{aligned}\]其中 $\text{diag}$ 为对角线矩阵,因为下标不同的项偏导为 0 ,只有对角线元素非 0。
假设隐藏层的激活函数 $f(\cdot)$ 为 $\tanh$ 函数。根据前向传播公式和 $\tanh$ 函数的导数形式,有
\[\begin{aligned} \boldsymbol h_t &= f(\boldsymbol{a}_t)\\ f'(\boldsymbol{a}_t) &= 1-\boldsymbol h_t\odot \boldsymbol h_t \end{aligned}\]
那么
\[\frac{\partial \boldsymbol h_{t+1}}{\partial \boldsymbol h_t} =\frac{\partial \boldsymbol h_{t+1}}{\partial \boldsymbol a_{t+1}} \frac{\partial \boldsymbol a_{t+1}}{\partial \boldsymbol h_t} = \boldsymbol{W}^T \text{diag}(f'(\boldsymbol{a}_t))\]带回隐层梯度公式有
\[\frac{\partial \boldsymbol L}{\partial \boldsymbol h_t} = \boldsymbol W^T \text{diag}(f'(\boldsymbol{a}_{t+1}))\cdot\frac{\partial \boldsymbol L}{\partial \boldsymbol h_{t+1}} + \boldsymbol V^T\nabla_{\boldsymbol o_t}\boldsymbol L\]稍作整理有
\[\nabla_{\boldsymbol h_t}\boldsymbol L = \boldsymbol W^T \text{diag}(f'(\boldsymbol{a}_{t+1}))\cdot\nabla_{\boldsymbol h_{t+1}}\boldsymbol L + \boldsymbol V^T\nabla_{\boldsymbol o_t}\boldsymbol L\]可以看出,隐层梯度 $\nabla_{\boldsymbol h_t}\boldsymbol L$ 可以采用递归的方式求解。
定义流入残差
\[\boldsymbol\delta_t:=\frac{\partial\boldsymbol L}{\partial\boldsymbol a_t} =\text{diag}(f'(\boldsymbol{a}_t))\,\nabla_{\boldsymbol h_t}\boldsymbol L\]对于 $\boldsymbol W$ 和 $\boldsymbol U$,需要进一步分析 $\boldsymbol a$ 对矩阵 $\boldsymbol W, \boldsymbol U$ 的偏导。因为
\[\boldsymbol a_t = \boldsymbol W \boldsymbol h_{t-1} + \boldsymbol U \boldsymbol x_t + \boldsymbol b\]对应分量式为
\[a_{t,i}=\sum_j W_{ij}h_{t-1,j}+\sum_k U_{ik}x_{t,k}+b_i\]则通过分量求导有
\[\frac{\partial L}{\partial W_{ij}}=\delta_{t,i}h_{t-1,j}\qquad \frac{\partial L}{\partial U_{ik}}=\delta_{t,i}x_{t,k}\qquad \frac{\partial L}{\partial b_i}=\delta_{t,i}\]则损失函数关于 $\boldsymbol W,\boldsymbol U,\boldsymbol b$ 的梯度表达式为
\[\begin{aligned} \frac{\partial\boldsymbol L}{\partial\boldsymbol b} &=\sum_t \boldsymbol\delta_t =\sum_t \text{diag}(f'(\boldsymbol{a}_t))\,\nabla_{\boldsymbol h_t} L \in\mathbb R^{D},\\ \frac{\partial\boldsymbol L}{\partial\boldsymbol W} &=\sum_t \boldsymbol\delta_t\,\boldsymbol h_{t-1}^{T} =\sum_t \text{diag}(f'(\boldsymbol{a}_t))\,\nabla_{\boldsymbol h_t} L\,\boldsymbol h_{t-1}^{T} \in\mathbb R^{D\times D},\\ \frac{\partial\boldsymbol L}{\partial\boldsymbol U} &=\sum_t \boldsymbol\delta_t\,\boldsymbol x_t^{T} =\sum_t \text{diag}(f'(\boldsymbol{a}_t))\,\nabla_{\boldsymbol h_t} L\,\boldsymbol x_t^{T} \in\mathbb R^{D\times M} \end{aligned}\]其中 $\boldsymbol h_t \in \mathbb R^D,\boldsymbol x_t \in \mathbb R^M$ 是列向量。
1.5. 梯度消失
RNN 存在时间维度上的梯度消失问题。
为了具体解释梯度消失的原因,首先将前面推导出来的 $t$ 时刻的 $\boldsymbol L$ 对隐层 $\boldsymbol h$ 的梯度递推过程列写如下
\[\nabla_{\boldsymbol h_t}\boldsymbol L = \boldsymbol W^T \operatorname{diag}(f'(\boldsymbol{a}_{t+1}))\cdot\nabla_{\boldsymbol h_{t+1}}\boldsymbol L + \boldsymbol V^T\nabla_{\boldsymbol o_t}\boldsymbol L\]做如下简写:
- 对角雅克比:$\boldsymbol A_t:=\boldsymbol W^T\operatorname{diag}(f’(\boldsymbol{a}_{t}))$
- 输出旁路:$\boldsymbol g_k:=\boldsymbol V^T\nabla_{\boldsymbol o_k}\boldsymbol L$
那么上式可以改写为
\[\nabla_{\boldsymbol h_t}\boldsymbol L = \boldsymbol A_{t+1}\nabla_{\boldsymbol h_{t+1}}\boldsymbol L + \boldsymbol{g}_t\]那么,对于 $t-1$ 时刻
\[\begin{aligned} \nabla_{\boldsymbol h_{t-1}}\boldsymbol L &= \boldsymbol A_t\nabla_{\boldsymbol h_t}\boldsymbol L+\boldsymbol g_{t-1}\\ &= \boldsymbol A_t\big(\boldsymbol A_{t+1}\nabla_{\boldsymbol h_{t+1}}\boldsymbol L+\boldsymbol g_t\big)+\boldsymbol g_{t-1}\\ &= \boldsymbol A_t\Big\{\boldsymbol A_{t+1}\big(\boldsymbol A_{t+2}\nabla_{\boldsymbol h_{t+2}}\boldsymbol L+\boldsymbol g_{t+1}\big)+\boldsymbol g_t\Big\}+\boldsymbol g_{t-1}\\ &= \boldsymbol A_t\boldsymbol A_{t+1}\cdots\boldsymbol A_T\nabla_{\boldsymbol h_T}\boldsymbol L\\ &\quad+\cdots\\ &\quad+\boldsymbol A_t\boldsymbol A_{t+1}\boldsymbol A_{t+2}\,\boldsymbol g_{t+1}\\ &\quad+\boldsymbol A_t\,\boldsymbol g_t\\ &\quad+\boldsymbol g_{t-1} \end{aligned}\]而对 $\tanh$ 及 $\tanh’$ 进行画图如下
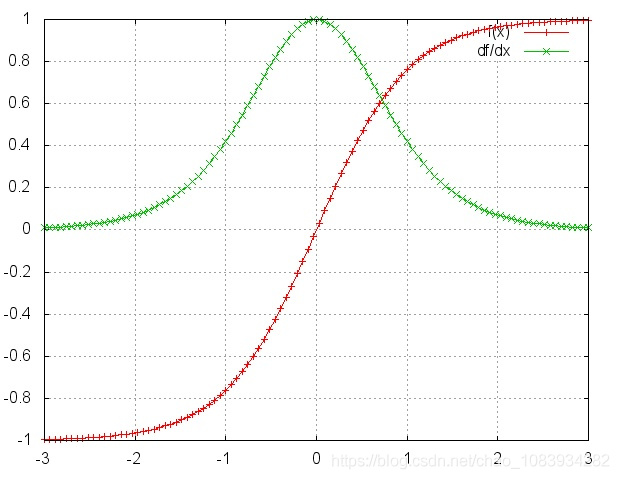
可以看出,由于 $\tanh’$ 的值域在 $(0,1)$ 之间,对于训练过程大部分情况下 $\tanh’$ 是小于 1 的。若 $\boldsymbol W^T$ 的取值较小导致对角雅克比矩阵的谱范数 $ \lVert\boldsymbol A\rVert \to 0$,导致长程梯度被压成0。这会导致较长时间 $t$ 前的梯度项 $\nabla_{\boldsymbol h_{t-1}}\boldsymbol L$ 中的第一项十分接近 0(最终时刻输出的误差无法产生影响),即导致较长时间 $t$ 前的 $\boldsymbol L$ 对参数的梯度项仅与那个时刻的输出有关。
也就是说,在时间维度上较前时刻的权重无法根据最终的 loss 信息来更新。RNN 中参数的梯度被近距离梯度主导,导致模型难以学到远距离的依赖关系。
注意,RNN 中总的梯度是不会消失的。即便梯度越传越弱,那也只是远距离的梯度消失,由于近距离的梯度不会消失,所有梯度之和便不会消失。
RNN 梯度消失的本质:由于时间维度共享了参数矩阵,导致计算隐态 $\boldsymbol h_t$ 的梯度时会循环计算矩阵乘法,所以 BPTT 算法求解梯度时出现了参数矩阵的累乘,使得当时间尺度过长时的隐层梯度丢失。
1.6. 梯度爆炸
另一方面,若 $\boldsymbol W^T$ 的取值较大,导致 对角雅克比 $ \boldsymbol A >1$,那么连乘的每一项均大于1,就会导致梯度爆炸现象。
梯度爆炸会使得学习不稳定, 参数变化太大导致无法获取最优参数。
2. 参考文献
[1] 刘建平Pinard. 循环神经网络(RNN)模型与前向反向传播算法.
[2] 维基百科. 矩阵微积分-布局约定.
[3] 仙守. 数学-矩阵计算(4)两种布局.
[4] 谓之小一. LSTM如何解决RNN带来的梯度消失问题.
[5] thinkando. 机器学习中的矩阵、向量求导.
[6] Leo蓝色. RNN正向及反向传播.
[7] 小米粥. RNN的反向传播-BPTT.
[8] StatQuest. 【官方双语】全网最简单易懂的 [RNN循环神经网络] 介绍,一个视频理解梯度消失和梯度爆炸.