在人工智能与知识管理领域,对知识的系统性认知与高效表示是实现智能推理和决策的基础。本文将从知识的本质出发,首先剖析知识的基本概念,明确其定义与分类,为后续探讨知识的表示与推理奠定理论基石;继而深入解析基于符号逻辑的多种知识表示方法,包括一阶谓词逻辑、产生式规则、框架式表示等经典范式,揭示逻辑推理的内在机制;同时,结合语义网技术,阐述以 RDF 为核心的知识表示体系及其在语义建模中的应用。通过理论与方法的结合,帮助读者构建对知识表示与推理的完整认知框架,为进一步探索智能系统的知识处理技术提供方向指引。
1. 知识的基本概念
1.1. 什么是知识
- 知识是人们在长期的生活及社会实践中、在科学研究及实验中积累起来的对客观世界的认识与经验
- 人们把实践中获得的信息关联在一起,就形成了知识
知识与人工智能的关系:
- 知识是智能的基础,为了使计算机具有智能,能够模拟人类的智能行为,就必须使它具有知识
- 人类的知识需要用适当的形式表示出来,才能存储到计算机中并被运用
1.2. 知识的分类
知识可以从不同的维度进行分类,以下是两种典型的分类情况:
-
规则性知识与事实性知识
规则性知识反映了信息间的某种因果关系,可以用 “如果……则……” 的形式来表示
例:“如果动物是鸟,则该动物是卵生生物”事实性知识反映了事物的某些性质
例如:“篮球是圆的”,“水是透明的” -
确定性知识与不确定知识
确定性知识:表示确定的规则或事实
例如:“如果这个粒子为电子,则这个粒子一定带负电”不确定性知识:事物与事物间的规则与联系是不确定和模糊的
例如:“如果今天阴天,则明天可能会下雨”
思考:能否列举一个「不确定的事实性」知识?
- “橡皮擦可能是圆的”
- “如果我理发,则我可能变帅”
1.3. 知识表示与推理
知识表示(Knowledge Representation)是指将知识以一种机器可理解的形式表示出来,它涉及数据结构及其处理机制的综合:
表示= 数据结构+处理机制
在知识表示中,知识的涵义与日常生活中的知识有所不同,它是指以某种结构化的方式表示的概念、事件和过程。
知识表示技术的变化大致可以分为三个阶段:
-
基于符号逻辑的表示:主要包括逻辑表示法(如一阶逻辑、描述逻辑)、产生式表示法和框架表示等。逻辑表示与人类的自然语言比较接近,是最早使用的一种知识表示方法。
-
基于RDF的表示:随着语义网概念的提出,万维网内容的知识表示技术逐渐兴起,基于万维网研发了资源语义元数据描述框架(Resource Description Framework,RDF),提供了一个用于描述实体/资源的统一标准。由于 RDF 只是定义了一个标准,需要采用基于标签的半结构置标语言XML(又被称为可扩展标记语言,eXtensible Markup Language)做为描述这种抽象的数据模型的具体书写方式,被称为 RDF/XML。在此基础上构建的大规模语义网络即知识图谱。
-
基于嵌入的表示:随着自然语言处理领域词向量等嵌入(Embedding)技术手段的出现,采用连续向量方式来表示知识的研究(TransE 翻译模型、SME、SLM、NTN、MLP,以及 NAM 神经网络模型等)正在成为现阶段知识表示的研究热点,并与上述以符号逻辑为基础的知识表示方法相融合。更为重要的是,知识图谱嵌入也通常作为一种类型的先验知识辅助输入到很多深度神经网络模型中,用来约束和监督神经网络的训练过程。
2. 符号逻辑表示与推理
2.1. 一阶谓词逻辑表示法
一阶谓词逻辑表示法(First-Order Predicate Logic, FOPL)是一种重要的知识表示方法,以数理逻辑为基础,是能够表达人类思维活动规律的一种精准的形式语言。一阶谓词逻辑表示法与人类的自然语言比较接近,可以被方便地输入到计算机中进行存储和运算。
2.1.1. 命题逻辑
命题逻辑是逻辑学的基础分支,研究由命题通过逻辑联结词构建复合命题的形式系统。系统由:
- 命题:又称为原子命题,是一个非真即假的陈述句,一个命题不可以同时为真又为假,但是可以在一种条件下为真,另一种条件下假。
- 连接词:
- 否定(非) $\lnot$
- 合取(且) $\land$
- 析取(或) $\lor$
- 蕴含(推出)$\to$
- 等价(当且仅当)$\leftrightarrow$
- 命题公式:通过有限次组合原子命题与联结词,按照递归定义规则生成。
以苏格拉底三段论为例:
1
2
所有人都会死;苏格拉底是人;所以,苏格拉底会死
所有人都会死;小明是人;所以,小明会死
定义如下命题:
- $p$:所有人都会死
- $q$:苏格拉底是人
- $r$:苏格拉底会死
- $s$:小明是人
- $t$:小明会死
则苏格拉底三段论可由命题逻辑表示为:
\[\begin{aligned} p\land q &\to r\\ p\land s &\to t \end{aligned}\]命题逻辑表示有较大的局限性:
- 无法把两者共同的特征表示出来。如 “李白是诗人” 和 “杜甫是诗人” 用命题逻辑就是两个字母 $p$, $q$(类似还有 “苏格拉底是人”和“小明是人”) ;
- 只能用完全独立的命题公式来表示逻辑结构一样但语义不同的情况(如上面两个三段论);
- 无法把它所描述的事物的结构即逻辑特征反映出来。 如 “老李是小李的父亲” 用命题逻辑就是一个字母 $y$,看不到内部的逻辑结构;
- 无法区分「所有人」这种全称量词,也无法表示「苏格拉底」、「小明」这种具体的个体。
由于这些原因,在命题逻辑的基础上发展起来了谓词逻辑。
2.1.2. 谓词逻辑
将命题按照三要素的方式继续拆解,形成谓词逻辑:
- 个体(词):表示具体 / 抽象的事物或对象,一般用小写字母表示。个体是命题中对事物或对象的指代,命题本身是对一个事物性质的直接描述,或是对几个事物之间关系的判断。个体通常可以替换为其他的实例,这种不确定性使得个体具有 “变量” 的意味,我们以小写字母 $x,y,z,\cdots$ 来表示个体,也可称为「个体变量」,如:
- $s$ - 苏格拉底
- $x$ – 小明
- 谓词:是对个体进行性质或关系的判断。谓词是从个体变量到真值的映射,使之具有 “函数” 的意味。我们通常使用大写字母 $P,Q,R,\cdots$ 或首字母大写的英文单词(及其组合)表示一个谓词,并在其后的括号中填入个体变量表示对其判断,如:
- $\text{P}(x)$ :$x$ 具有性质 $\text{P}$
- $\text{IsHuman}(a)$:$a$ 是人
- $\text{WillDie}(a)$:$a$ 会死
- $\text{P}(x_1,x_2,x_3,\cdots,x_n)$ 表示更加复杂的多元谓词
- 量词:刻画数量范围。量词的引入使得更为复杂的知识表示成为可能,量词也是区分命题逻辑和谓词逻辑的关键概念:
- 全称量词 $\forall$:
\forall所有、任意 - 存在量词 $\exists$:
\exists存在、有一些
- 全称量词 $\forall$:
以苏格拉底三段论为例,可直观看出谓词逻辑相较于命题逻辑的改进:
-
命题逻辑:
- 人都会死 $p$,苏格拉底是人 $q$,苏格拉底会死 $r$:$(p\land q)\rightarrow r$
- 人都会死 $p$,小明是人 $s$,小明会死 $t$:$(p\land s)\rightarrow t$
- 无法归纳出其中的共性。
-
一阶谓词逻辑:
思考:如何表述?
- 人都会死:$\forall x\;\text{People}(x)\rightarrow \text{Die}(x)$
- 归纳给共性并形成逻辑特征:
- 人都会死,苏格拉底是人,苏格拉底会死:$\text{People}(S)\rightarrow \text{Die}(S)$
- 人都会死,小明是人,小明会死:$\text{People}(M)\rightarrow \text{Die}(M)$
全称量词和存在量词出现的次序会影响命题的意思:
尝试解读如下两个命题: (1)\(\forall x\; \exists y\;(\text{Student}(x)\to \text{Teacher}(y,x))\) (2)\(\exists y \;\forall x\; (\text{Student}(x)\to \text{Teacher}(y,x))\)
- (1)每个学生都有一个老师
- (2)有一个人是所有学生的老师
2.1.3. 一阶谓词逻辑
2.1.3.1. 性质
若谓词逻辑具备以下性质,则称之为「一阶谓词逻辑」:
- 量词仅能约束「个体」,不能约束谓词
- 谓词不能作为变元被量化
一阶谓词逻辑中,个体是常量,变量或函数,如:
-
个体可以是常量:例如 “老张是教师” 可以用谓词逻辑表示为:
\[\text{IsTeacher}(zhang)\]$\text{IsTeacher}$ 这个谓词名刻画了 $zhang$ 这个个体是教师这一性质。
-
个体可以是变量:例如 $x<5$ 可以用谓词逻辑表示为:
\[\text{Less}(x,5)\]Less 这个谓词名刻画了个体 $x$ 比个体 $5$ 小这一关系。当 $x$ 有具体的值的时候,这个谓词就有了具体的真 $T$ 或假 $F$ 的判定。同时,个体也存在个体域的概念,也即个体变量的取值范围。
-
个体可以是函数(即个体函数):例如 “小李的父亲是教师” 可以用谓词逻辑表示为:
\[\text{IsTeacher}(\text{father}(li))\]其中,$\text{father}(li)$ 是一个函数,返回值还是一个个体,无法判断真假。 而谓词名 $\text{IsTeacher}$ 刻画了这个个体 $\text{father}(li)$ 的职业是教师这一性质,是可以判断真假的。 类似的二元谓词 $\text{IsFatherOf}(x, li)$ 作用于个体 $x$ 上生成命题,返回值是「$x$ 是否为 $li$ 的老师」这一命题的真假判断。
相比于命题逻辑,一阶谓词逻辑的优势如下:
- 一个事实性陈述:“A是B的老师”,命题逻辑只能将其定义为一个 $p$,而一阶谓词逻辑可以刻画其中的关系:
- 可以构建二元谓词表示更加复杂的逻辑,如 “小李的妹妹和小张的哥哥结婚” 可以表示为:
- 个体(函数)还可以递归调用,例如 “小李的祖父” 可以表示为:
尝试用一阶谓词逻辑描述如下命题 Smith 作为一个工程师为 IBM 工作
\[\text{WorkFor}(\text{IsEngineer}(Smith), IBM)\]2.1.3.2. 论域与特征谓词
注意以下两个例子:
- (1)规则知识:“如果动物是鸟,则动物是卵生生物”
- (2)事实知识:“鸟是卵生动物”
虽然二者很相似,但在知识表示中完全不同。一个朴素的例子为:
graph TD
A["麻雀是鸟"] --> B{"(1)动物是鸟?"}
C["麻雀是动物"] --> B
B -->|是| D["麻雀是卵生生物"]

F["麻雀是鸟"] --> G["麻雀是卵生生物"]
H["(2)鸟是卵生生物"] --> G
可以看出,类似的知识,可能按照不同的方式进行表示。
采用一阶谓词逻辑,“鸟是卵生动物” 可表示为:
\[\forall bird\; \text{From}(bird, egg)\]或者表示为:
\[\forall x\; \text{From}(x, egg)\]此时需要限定个体变量 $x$ 存在的范围(此例中为鸟类),称其为 论域(类似变量的定义域)。
如果扩大论域,显然可能会导致命题失效,比如将 $x$ 扩大为动物,此时为了保证原命题成立,需要额外引入一个谓词,以限定论域的范围,这个额外引入的谓词被称为 特征谓词。此时有
\[\forall x\; (\text{Bird}(x)\to \text{From}(x, egg))\]2.1.3.3. 语法和语义
一阶谓词逻辑作为严格的形式逻辑系统,核心由两套相互独立又紧密关联的体系构成:语法系统(符号规则体系)和语义系统(含义与真值体系)。简单来说,语法规定“符号怎么写、怎么推导”,不涉及任何实际含义;语义定义“符号代表什么、命题如何判定真假”,依托具体模型完成真值判断。
(1)语法(syntax):纯符号的形式规则,无真假属性
语法是一阶逻辑的符号规范与推理规则集合,完全剥离实际语义,仅关注符号的合法性与推导合规性,不讨论命题的真、假。 语法的核心作用:
- 规定合法公式:明确哪些符号组合是符合逻辑规范的有效公式;
- 规定推理规则:明确如何通过已知公式,通过固定形式规则推导出新公式。
举个例子:公式 $\forall \; x(P(x)\to Q(x))$
- 从语法层面仅能判定:该公式符号组合合规、结构合法,可依据一阶逻辑公理、推理规则进行形式推导。全程无需知晓变量 $P,Q,x$ 的实际含义。
- 通俗类比:语法等同于象棋规则,仅规定“棋子的合法走法”,只判定操作是否合规,不关注棋子、棋局对应的现实意义。
(2)语义 / 模型(model):赋予符号含义,判定命题真假
语义是对语法符号的现实解释体系,通过构建一个具体的“讨论世界”(模型),为所有抽象逻辑符号绑定实际意义,最终为每一个合法公式确定唯一的真值(真/假)。
一阶逻辑的一个模型 $\mathcal{M}$ 包括:
- 论域 $D$:当前逻辑讨论的全部对象集合,是所有变量、常量的取值范围,比如动物集合或者自然数集合 $\mathbb{N}$。
- 常量解释:将公式中的常量符号,对应到论域中的具体个体(如常量 $a$ 对应为论域中的猫)
- 谓词解释:将抽象谓词符号,对应论域中个体的性质或个体间的关系(如谓词 $P(x)$ 解释为 $x$ 是哺乳动物)
- 函数解释:将抽象函数符号,对应论域中个体的映射关系(如后继函数 $S(x)$ 解释成自然数运算 $x+1$)
符号完成全部绑定后,任意一个语法合法的公式,在该模型中都有确定的真假值。
(3)语法与语义的核心关系:同一语法,多组语义
一阶逻辑中,语法是固定的、抽象的,语义是可变的、具体的。同一套合法的语法公式,代入不同模型(不同论域、不同符号解释),会产生完全不同的语义结果(真值不同)。
以通用语法公式 $\forall x\; P(x)$ (对所有个体 $x$,$x$ 满足性质 $P$)为例:
- 模型 1:论域 ={猫,狗,兔子},$P(x)$:$x$ 是哺乳动物。 在这个模型里,公式为真,所有对象都是哺乳动物。
- 模型 2:论域 ={猫,石头,树},$P(x)$:$x$ 是哺乳动物。 在这个模型里,公式为假,石头不是哺乳动物。
可以看出,语法是剥离具体含义的符号,没有真假之分,只有合法非法的区别。而同一个语法公式,可以在 A 模型为真,在 B 模型为假。模型就是给这套逻辑公式造一个 “小世界”,用来判定公式真假。
2.1.3.4. 完备性与不可判定性
明确语法、语义的独立定义后,核心问题应运而生:一阶逻辑的语法推导能力,能否完全匹配语义层面的逻辑真理? 哥德尔完备性定理精准回答了这一核心问题,建立了语法可证性与语义真值性的等价关系。
(1) 语法可证:$\mathbb{\Gamma} \vdash \varphi$
设 $\Gamma$ 为一阶逻辑公式集(前提 / 公理,可有限、可无穷),$\varphi$ 是待推导的目标公式。若存在有限长度的公式序列 $\varphi_1,\varphi_2,\dots,\varphi_n$,满足以下全部条件,则称 $\varphi$ 可由 $\Gamma$ 语法可证,记为 $\Gamma \vdash \varphi$
- 序列最后一个公式 $\varphi_n = \varphi$
- 序列中的每一个公式 $\varphi_i$ 必属于以下三类之一:
- 属于前提集合 $\Gamma$;
- 一阶逻辑的通用公理(重言永真式、量词公理等);
- 由序列中前面的公式,通过标准推理规则推导得出(如肯定前件规则 MP,即由:$\alpha, \alpha\to \beta$ 可推出 $\beta$)
关键性质:即便前提集 $\Gamma$ 包含无穷多条公式,任意一次语法证明仅需用到其中有限条公式。整个证明过程是纯粹的符号替换、形式推演,无需依托模型、无需理解符号含义、无需判断真值。
(2)语义蕴含:$\mathbb{\Gamma} \models \varphi$
若对于 $\mathcal{M}$ 任意一个模型 ,只要 $\mathcal{M}$ 满足前提集 $\Gamma$(即 $\Gamma$ 中所有公式在该模型中均为真),就必然满足目标公式 $\varphi$(即 $\varphi$ 在该模型中为真),则称 $\Gamma$ 语义蕴涵 $\varphi$,记为 $\Gamma \models \varphi$。
通俗解读:语义蕴涵代表绝对的逻辑必然——在所有可能的解释世界(模型)中,只要前提全部成立,结论就绝对不可能为假,结论是前提固有的逻辑结果。
(3)哥德尔完备性定理
1929年,哥德尔证明了一阶谓词逻辑的完备性定理,搭建起语法可证与语义永真的双向等价桥梁,是一阶逻辑体系的基石定理。定理可表述为:在一阶谓词逻辑系统中,对任意公式集 $\Gamma$ 和任意公式 $\varphi$,满足
\[\mathbb{\Gamma} \vdash \varphi \Longleftrightarrow \mathbb{\Gamma} \models \varphi\]对于包括一阶谓词逻辑在内的一阶逻辑推理系统,哥德尔完备性定理表明:
-
可靠性:语法可证 ⇒ 语义成立 凡是能通过形式推理证明的公式,在所有模型中必然为真,一阶逻辑推理系统无谬误、不推假结论。
-
完备性:语义成立 ⇒ 语法可证 凡是在所有模型中恒成立的逻辑真理(语义蕴涵有效),一定存在有限步形式证明序列,可通过一阶逻辑公理与规则严格推导出来。
(4)不可判定性
哥德尔完备性定理仅保证「永真公式一定有有限证明」,但不代表一阶逻辑可判定:
- 一阶逻辑是半可判定的:若公式是永真式,可通过遍历证明序列最终找到证明;
- 若公式不是永真式,不存在通用算法,能在有限步骤内判定其非永真,程序可能无限遍历、无法终止。
从另一个角度出发,可以将任意一个图灵机停机问题,机械编码为一个一阶逻辑公式,这个编码是机械、普适的。由此得到等价核心定理:对任意图灵机 $M$、任意输入 $w$,$M(w)$ 能够停机 $\iff$ 对应的一阶公式 $\Phi_{M,w}$ 是一阶永真式(语义恒真)。
若一阶逻辑是可判定的,即存在通用算法,能有限步判定任意一阶公式是否为永真式。那么我们可通过「编码+判定」两步有限算法,解决停机问题:① 对任意 $(M,w)$,机械编码生成 $\Phi_{M,w}$;② 用一阶逻辑判定算法判断其是否为永真式,即可判定 $M(w)$ 是否停机。这与图灵机停机问题不可判定的已证结论矛盾,因此假设不成立。因此一阶谓词逻辑是不可判定的。
2.1.4. 高阶谓词逻辑
如果量词约束「谓词」,或把谓词当作变元放进另一个谓词,即为二阶谓词逻辑。
如描述「莱布尼茨定律(同一不可分辨性)」需要用到二阶谓词逻辑:
1
对于任意个体 x 和 y , 只要 x 和 y 相等, 那么 x, y 具有相同的性质
其中,全称量词 $\forall$ 约束了谓词 $P$,且谓词 $P$ 可被量化为某个具体的性质。
一阶(first-order)限制只能对变量使用量词,也就是数学上「对于所有的 ${E}\in \mathbb{R}$,有……」这样的语句是不能写成一阶逻辑的语言的,因为这里对谓词使用了全称量词。特别地,标准的自然数模型的定义是二阶的,因为数学归纳法是一个二阶性质(second-order property)。
皮亚诺公理是一套由意大利数学家朱塞佩·皮亚诺在1889年提出的自然数公理体系,满足这类性质的集合均与自然数集同构。皮亚诺公理一共 5 条:
- $0 \in \mathbb{N}$ :0 是自然数
- $n\in \mathbb{N} \to n^{+}\in \mathbb{N}$:若 $n$ 是自然数,则其后继 $n^+$ 是自然数
- $\lnot \exists n(n\in \mathbb{N} \land n^+=0)$:$0$ 不是任何数的后继
- $m^+=n^+\to m=n$:后继是单射,不同的自然数有不同的后继
- 有限归纳公理(两种等价表述形式):
- 「集合语言表述」:一个集合 S 等于全体自然数集合 $\mathbb{N}$,当且仅当:S 是 $\mathbb{N}$ 的子集,包含 0,并且对后继封闭(只要$n\in S$,后继$n^+$也在 $S$) $S=\mathbb{N} \leftrightarrow \big( S \subset \mathbb{N} \land 0\in S \land (\forall n (n\in S \to n^+ \in S)) \big)$ 这里变量 $S$ 是集合变量,遍历 $\mathbb{N}$ 的所有子集,属于二阶量化
- 「标准谓词表述」: 任何性质 $P$,如果 0 满足,且 $x$ 满足可推出后继 $x^+$ 满足,那么全体自然数都满足。 $\forall P\Big(\big(P(0)\land \forall x(P(x)\to P(x^+))\big)\to \forall x\,P(x)\Big)$ “任何性质”,就是对全部子集做全称量化,这一个二阶表达。
在标准语义下,二阶谓词逻辑「不满足」哥德尔完备性定理:也即存在公式,在所有模型里都为真(语义永真),但不存在有限形式证明。 根源在于标准语义要求谓词变量遍历论域的全部子集,子集总数是不可数无穷;而形式证明只能是有限符号序列,无法捕获这种极强的语义约束。
可数无穷:可以和全体自然数 $\mathbb{N}={0,1,2,3,\dots}$ 建立一一对应(双射)
- 自然数集 $\mathbb{N}$:本身就是可数无穷。
- 整数集 $\mathbb{Z}={\dots,-2,-1,0,1,2,\dots}$:可以重新排列 $0,-1,1,-2,2,-3,3,\dots$,一一对应自然数,可数无穷。
- 有理数集 $\mathbb{Q}$:所有分数,可以用对角线枚举法排成序列,可数无穷。
- 二阶逻辑的字符集是有限的($\forall,\exists,P,x,(),\land,\to,\dots$) 长度为 1 的字符串有限;长度为 2 的有限;长度n的有限 我们依次枚举:所有长度 1 合法串,长度 2 合法串,长度 3……,于是全部合法公式、全部有限证明序列,都可以编号,构成可数无穷集合
不可数无穷:一个无穷集合,如果不能和自然数建立一一对应,就叫不可数无穷。 康托定理:对任意集合 A,其幂集 $\mathcal{P}(A)$(A 的所有子集构成的集合)的基数严格大于集合 A 本身的基数。
- 我们取 $A=\mathbb{N}$(自然数,可数无穷)。 $\mathcal{P}(\mathbb{N})$ 是全体自然数子集:${\emptyset,{0},{1},{0,1},{2,5,7},\dots}$。
由康托定理:$ \mathcal{P}(\mathbb{N}) > \mathbb{N} $。 - 因为自然数是可数无穷,所以自然数所有子集构成不可数无穷集合。
2.1.5. 推理规则
基于前述一阶谓词逻辑的定义,我们想要对命题进行推理,以便确定命题的真假。推理需要一定的规则,在特定假设下能获得特定结论。
假设有公式 $\phi_1, \phi_2,\cdots, \phi_n$ 被称为 前提,和另外一个公式 $\psi$ 被称为 结论,我们希望在使用一系列证明规则后,通过假设能得到结果
\[\phi_1, \phi_2,\cdots, \phi_n \vdash \psi\]上式被称为相继式(sequence),如果可以建立证明,就称他为有效的(valid)。符号 $\vdash$ 是句法后承(syntactic consequence)关系。上式读作 “$\psi$ 可证明自 $\phi_1, \phi_2,\cdots, \phi_n$”。
一阶谓词逻辑的推理论证与命题逻辑类似,一共包含以下九个 基本推理规则:
-
合取规则
-
合取引入(and-introduction)
\[\frac{P \quad Q}{P\land Q}\] -
合取除去(and-elimination)
\[\frac{A \land B}{A}\quad \frac{A \land B}{B}\]尝试证明: \(P\land Q, R \vdash Q \land R\)
证明:
\[\frac{\frac{P \land Q}{Q}\quad R}{Q\land R}\]
-
-
双重否定
\[\frac{\lnot \lnot P}{P} \quad \frac{P}{\lnot \lnot P}\]尝试证明: \(P, \lnot \lnot (P\land Q) \vdash \lnot \lnot P\land Q\)
证明:
\[\frac{\frac{P}{\lnot \lnot P}\quad \frac{\frac{\lnot \lnot (P\land Q)}{P\land Q}}{Q} }{\lnot \lnot P\land Q}\] -
蕴含消去
-
肯定前件(分离规则) \(\frac{P\to Q, P}{Q}\)
-
否定后件(反证规则,拒取式) \(\frac{P\to Q, \lnot Q}{\lnot P}\)
思考:下面的命题是否成立? \(\frac{P\to Q, \lnot P}{\lnot Q}\)
不成立。比如,“如果下雨地一定湿”
否定后件表述为:如果地没湿则一定没下雨(为真)
但上述表述为:如果没下雨则地一定没湿(不一定)
-
-
假言推导(蕴含引入)
\[\frac{\begin{bmatrix} P\\ \vdots\\ Q \end{bmatrix}}{P\to Q}\]- 也就是说,为了证明 $P\to Q$,先短暂假设 $P$ 成立,再证明 $Q$,这个假设在框外不再成立。
-
紧跟在关闭矩形框后的行必须与使用该矩形框的规则所得到的结论 模式匹配,就蕴含引入而言,如果矩形框第一个公式是 $P$,最后一个公式是 $Q$,那么该矩形框后面的行必须是 $P \to Q$。
尝试用假言推导证明如下经典命题: \(P\to Q \vdash \lnot Q \to \lnot P\)
证明:
\[\frac{\begin{bmatrix} \frac{P\to Q \quad \lnot Q}{\lnot P} \end{bmatrix}}{\lnot Q \to \lnot P}\]
-
析取规则
-
析取引入
\[\frac{P}{P\lor Q} \quad \frac{Q}{P\lor Q}\] -
析取消除
\[\frac{P\lor Q\quad\begin{bmatrix} P\\ \vdots\\ A \end{bmatrix} \quad \begin{bmatrix} Q\\ \vdots\\ A\end{bmatrix}} {A}\] -
对于析取消除,由于不知道 $P, Q$ 哪一个为真,必须给出两个单独的证明,在合成一个论断。
-
由于量词的引入,一阶谓词逻辑的推理还有四个额外推理规则:
-
全称量词消除(Universal Specification, US):
\[\forall x\; P(x) \Rightarrow P(c)\]- $c$ 为个体域中任一确定元素
- 前提:所有人都会死 $\forall x\; (\text{People}(x)\to \text{Die}(x))$
- 结论:苏格拉底会死 $\text{People}(Socrates)\to \text{Die}(Socrates)$
-
全称量词引入(Universal Generalization, UG):
\[P(c) \Rightarrow \forall x\; P(x)\]- $c$ 为个体域中任一确定元素
- 如果在推理过程中,对于个体变量 $c$ 的一个任意但固定的选择($c$ 不在前提中的任何公式中自由出现),我们证明了命题 $A(c)$ 为真,那么我们可以合法地在推理的下一步引入全称量词,得到 $\forall x\; P(x)$。
- 一个我们很熟悉的例子,那就是“毕达哥拉斯定理”。随手在纸上画一个“直角三角形”,证明直角边的平方和,等于斜边的平方。就可以推广到所有的直角三角形。
-
存在量词消除(Existential Specification, ES):
\[\exists x\; P(x) \to P(c)\]- 前提:有一些美国总统来自德州
- 结论:某个美国总统来自德州
- 需要注意到,这 “某个美国总统”,是有限制的。德州出来的总统总共只有那么几个,那么 “某个美国总统” 可以肯定就是他们当中的一个。
-
存在量词引入(Existential Generalization, EG):
\[P(c) \to \exists x\; P(x)\]- 爱因斯坦是天才 $\to$ 存在天才:$\text{Genius}(Einstein)\to \exists x\;\text{Genius}(x)$
详细参考《离散数学》
尝试证明: \(\forall x\forall y (P(x,y)\to W(x,y)), \; \lnot W(a,b)\quad \vdash \quad \lnot P(a,b)\)
证明:
(1) $\forall x\forall y (P(x,y)\to W(x,y))\quad$ [前提]
(2) $\forall y (P(a,y)\to W(a,y))\quad$ [(1),US]
(3) $P(a,b) \to W(a,b)\quad$ [(2), US]
(4) $\lnot W(a,b)\quad$ [前提]
(5) $\lnot P(a,b)\quad$ [(4),拒取式]
尝试证明: 前提:$\exists x\;(\text{Cat}(x)\land \text{Catch}(x,rat))$,证明:存在抓老鼠的动物
证明:
(1) $\exists x\;(\text{Cat}(x)\land \text{Catch}(x,rat))\quad$ [前提]
(2) $\text{Cat}(c)\land \text{Catch}(c,rat)\quad$ [(1),ES]
(3) $\text{Catch}(c,rat)\quad$ [合取除去]
(4) $\exists y \;\text{Cat}(y,rat)\quad$ [(3),EG]
2.1.6. 归结原理
归结演绎推理是基于一种称为归结原理(亦称消解原理,Resolution Principle)的推理规则的推理方法。归结原理是由鲁滨逊(J.A.Robinson)于 1965 年首先提出。其核心是通过归结操作推导空子句以验证命题的「不可满足性」,它是谓词逻辑中一个相当有效的机械化推理方法。归结原理的出现,被认为是自动推理,特别是定理机器证明领域的重大突破。
归结原理的核心是「合一消解」操作。
-
消解
消解是一种推理规则。它非常强大,对于命题逻辑和一阶谓词逻辑都是完备的,这意味着只要一个结论是逻辑蕴含的,就可以通过反复应用消解规则来证明它。其基本思想是:从两个子句中找出一对互补的文字,将它们去掉,然后将两个子句中剩下的部分合并成一个新的子句。例如,假设有两个子句:
\[A \lor B \lor \lnot C\] \[C \lor D\]这里,$\lnot C$ 和 $C$ 是一对互补文字。应用消解规则后,我们得到的新子句是:$A \lor B \lor D$。
因为:如果 $C$ 为假,则 $D$ 必须为真(来自第二个子句);如果 $C$ 为真,则 $A \lor B$ 必须为真(来自第一个子句)。所以无论如何,$A \lor B \lor D$ 都必须为真。
-
合一
在一阶谓词逻辑中,事情变得复杂了,因为我们处理的是包含变量、函数和谓词的表达式,而不仅仅是简单的命题符号。
- 问题:如何对两个像 $\lnot P(x)$ 和 $P(a)$ 这样的子句进行消解?
它们并不直接互补。$\lnot P(x)$ 是一个带变量的谓词,而 $P(a)$ 是一个常量。我们需要一个方法让 $P(x)$ 和 $P(a)$ 变得相同,从而使 $\lnot P(x)$ 和 $P(a)$ 成为互补对。合一就是解决这个问题的技术。
-
定义:合一是一种寻找一个替换的过程,该替换可以使得两个或多个表达式变得相同。这个替换被称为最一般合一者。
-
替换:是一组形如 {变量/项} 的集合,例如 {x/a, y/f(b)}。应用这个替换意味着把表达式中的所有变量都替换成对应的项。
-
MGU:最一般合一者是最一般的(最抽象的)那个替换,它只为了使表达式相同而进行必要最小量的替换。其他所有能使表达式相同的替换都是这个MGU的实例。
-
举例:要使 $P(x, f(y))$ 和 $P(a, f(g(z)))$ 相同,我们需要:
- 让第一个参数相同:用 $a$ 替换 $x$。替换: ${x/a}$
- 让第二个参数的函数名相同:它们都是 $f$,很好。
- 让 $f$ 的参数相同:第一个是 $y$,第二个是 $g(z)$。所以我们需要用 $g(z)$ 替换 $y$。替换:${y/g(z)}$
- 所以,最一般合一者就是 ${x/a, y/g(z)}$。
举例:给定以下知识库(CNF 形式):
-
(1) $\lnot P(x) \lor Q(f(x))$
-
(2) $\lnot Q(y) \lor R(g(y))$
-
(3) $P(a)$
需要证明:
- (4) $\exists z\; R(z)$
在归结原理中,我们采用反证法(即假设 $R(z)$ 不成立)。将这个否定假设(即 $\lnot R(z)$)加入到知识库中。如果从这个新的子句集合中能推导出空子句($\square$,代表矛盾或假),那么就证明了我们最初的假设是错误的。因此,原结论 $R(z)$ 必须为真。
-
步骤 1:归结子句 (1) 和 (3)
-
子句 1: $\lnot P(x) \lor Q(f(x))$
-
子句 3: $P(a)$
-
互补文字:$\lnot P(x)$ 和 $P(a)$,通过合一 ${x/a}$ 消解
-
归结式:$Q(f(a))$(新子句 5)
当前子句集:
-
(1) $\lnot P(x) \lor Q(f(x))$
-
(2) $\lnot Q(y) \lor R(g(y))$
-
(3) $P(a)$
-
(4) $\lnot R(z)$(引入的假设)
-
(5) $Q(f(a))$
-
-
步骤 2:归结子句 (5) 和 (2)
-
子句 5: $Q(f(a))$
-
子句 2: $\lnot Q(y) \lor R(g(y))$
-
互补文字:$Q(f(a))$ 和 $\lnot Q(y)$,通过合一 ${y/f(a)}$ 消解
-
归结式:$R(g(f(a)))$(新子句 6)
当前子句集:
-
(1) $\lnot P(x) \lor Q(f(x))$
-
(2) $\lnot Q(y) \lor R(g(y))$
-
(3) $P(a)$
-
(4) $\lnot R(z)$(引入的假设)
-
(5) $Q(f(a))$
-
(6) $R(g(f(a)))$
-
-
步骤 3:归结子句 (6) 和 (4)
-
子句 6: $R(g(f(a)))$
-
子句 4: $\lnot R(z)$(引入的假设)
-
互补文字:$R(g(f(a)))$ 和 $\lnot R(z)$,通过合一 ${z/g(f(a))}$ 消解
-
归结式:$\square$(空子句,矛盾)
-
由于导出了空子句 $\square$,说明原子句集是矛盾的,即 $\exists z\;R(z)$ 与知识库同时成立。具体地,存在 $z=g(f(a))$ 是的 $R(z)$
2.2. 产生式表示法
产生式表示法,也称为规则表示法,由美国数学家波斯特(E.POST)在1943年首先提出。1972年,纽厄尔和西蒙在研究人类的认知模型中开发了基于规则的产生式系统,产生式表示法已经成了人工智能中应用最多的一种知识表示模式,尤其是在专家系统方面,许多成功的专家系统都是采用产生式知识表示方法。
2.2.1. 基本形式
产生式表示法的基本形式是:
IF <前提> THEN <结论/动作></span>
它描述了一个 “条件-行为” 对:如果某个条件成立,那么就执行某个操作或得出某个结论。这个术语来源于形式语言理论中的 “产生式规则”(例如,在巴科斯-诺尔范式 BNF 中,用 $::=$ 来定义语法结构),但在知识表示中,它的含义更接近于逻辑中的“蕴含式”(Implication),即 $P \to Q$。
一个典型的产生式规则由三部分组成:
-
前提(条件部分 / IF 部分):也称为左部(Left-Hand Side, LHS)。它是一个或一组条件,可以是逻辑组合(与、或、非)。
例如:(温度 > 38.5℃) AND (咳嗽 == True)
-
结论(动作部分 / THEN部分):也称为右部(Right-Hand Side, RHS)。当前提被满足时,所执行的操作或所得的结论。
例如:THEN 诊断为“疑似流感” 或 THEN 开出药物“奥司他韦”
-
可信度(可选):在不确定推理中,可以为规则附加一个可信度因子(Certainty Factor, CF),表示前提成立时,结论为真的概率或置信程度。
示例:
1
2
3
4
5
6
7
8
9
10
11
规则 R1:
IF    动物有毛发
THEN  该动物是哺乳动物   (CF=0.9)

规则 R2:
IF    动物产奶
THEN  该动物是哺乳动物   (CF=1.0)

规则 R3:
IF    动物是哺乳动物 AND 动物有蹄
THEN  该动物是有蹄类动物
2.2.2. 推理方法
产生式表示法的推理方法包括:
- 前向推理(Forward Chaining),也称为 “Horn 规则推理”,或称为数据驱动方式,是一种基于规则的推理方法,它通过将规则的左部作为输入,将规则的右部作为输出,并重复执行此过程,直到所有规则都被执行完毕,或通过规则库求得结论。正向推理会得出一些与目标无直接关系的事实,是有浪费的。
思考:能否举例说明?
如,已知病人感染了某疾病,推理出他有什么症状。可能推理出:生病–意识模糊–长期卧床–肌肉萎缩
- 后向推理(Backward Chaining),也称为“ 逆向规则推理”,或称为目标驱动方式,是一种基于规则的推理方法,它通过将规则的右部作为输入,将规则的左部作为输出,并重复执行此过程,直到所有规则都被执行完毕。如果目标明确,使用反向推理方式效率较高。
思考:能否举例说明?
如,已知病人出现发烧、胸闷、气短的现象,推理出病人得了什么病。此时规则库中一般会包含大量某疾病导致某些症状的规则,便于反向推理。
- 双向推理(Bidirectional Chaining),也称为 “双向规则推理”,是一种基于规则的推理方法,它同时执行前向推理和后向推理,直到所有规则都被执行完毕。
不管是何种推理规则,在执行过程中都会得到不只一条规则被满足,此时推理机需要根据某种策略(如优先级、特异性、新近度等)选择一条规则来执行。
产生式表示格式固定,形式单一,规则(知识单位)间相互较为独立,没有直接关系使知识库的建立较为容易,处理较为简单的问题是可取的。另外推理方式单纯,也没有复杂计算。特别是知识库与推理机是分离的,这种结构给知识的修改带来方便,无须修改程序,对系统的推理路径也容易作出解释。所以,产生式表示知识常作为构造专家系统的第一选择的知识表示方法。
2.3. 框架式表示法
框架式表示法是一种基于人类理解和记忆事物方式的知识表示方法,非常擅长描述具有固定结构的典型对象、概念或事件。
框架(Frame) 是由 Marvin Minsky 在 1974 年提出的一种知识表示理论。其核心思想是: 当人们遇到一个新情况时,会从记忆中找到一个被称为“框架”的结构化数据结构。这个框架提供了一个大致的轮廓,人们通过用新情况的细节填充这个框架来理解和应对它。
一个框架就像一张体检表、一份入职申请表或一个产品目录,它预先定义好了需要填写哪些栏目,你只需要根据具体的人或物填入具体信息即可。
2.3.1. 框架的定义
一个框架主要由 「框架名」 和一系列 「槽(Slot)」 组成。每个槽又可以包含多个 「侧面(Facet)」 来说明该槽的细节。
- 框架名:标识这个框架所描述的主题或类别。
- 例如:
笔记本电脑、员工、会议室预订事件
- 例如:
- 槽:描述了框架所代表实体的各个属性或组成部分。
- 例如:对于
笔记本电脑框架,它的槽可以有:品牌、型号、CPU、内存、硬盘等。 - 例如:对于
员工框架,槽可以有:姓名、工号、部门、职位、薪资等。 -
思考:会议室预订事件可以有哪些槽?
如,会议时间、房间号(地点)、参会人员等。
- 例如:对于
- 侧面:是槽的进一步细化,用于描述槽的附加信息。最常见的侧面有:
- 值(Value):该属性的具体取值。这是最核心的侧面。
- 默认值(Default):当没有明确信息时,该属性的典型值。例如,“鸟”的框架中,“会飞”的默认值可能是“是”,但鸵鸟这个实例会将其覆盖为“否”。
- 值类型(Type):规定该槽的取值范围,如
数字、字符串、布尔值,甚至是另一个框架。 - 范围(Range):规定值的区间,如
1-100。 - 可选【一段程序(过程附件)】,当需要该槽的值但当前未知时,会自动调用这段程序来计算或获取值(例如,通过询问用户)。
- 可选【一段程序(后处理)】,当该槽被填入新值后,自动触发执行(例如,更新数据库或其他相关槽的值)。
2.3.2. 层次与继承
框架表示法的一个强大特性是它天然支持层次结构(继承)。
- AKO(A-Kind-Of): 用于表示类与子类的关系(类属关系)。
- 例如:
轿车框架的AKO槽的值是汽车。这意味着“轿车是一种汽车”,因此轿车框架可以继承汽车框架的所有槽(如都有轮子、发动机),并增加自己特有的槽(如轿车车型)。
- 例如:
- ISA(Is-A): 用于表示 「实例与类」的关系(实例关系)。
- 例如:一个具体的对象
我的电脑框架的ISA槽的值是笔记本电脑。这意味着 “我的电脑是一台笔记本电脑”,因此它继承了笔记本电脑框架的所有属性,并为各个槽填上了具体的值(如品牌:Dell,型号:XPS 13)。
- 例如:一个具体的对象
这种继承机制极大地减少了信息冗余,实现了知识的重用。
2.3.3. 示例
假设我们要描述 “一辆具体的汽车”。
-
首先,我们有一个上层框架(类):
1
2
3
4
框架名:  【汽车】 AKO: 交通工具
轮子数量: 默认值: 4
发动机:   值类型: 框架
功能:     行驶
-
然后,定义一个更具体的子类框架:
1
2
框架名:  【轿车】 AKO: 【汽车】
车型:     值类型: 字符串,范围: [普通, 跑车, 敞篷]
-
最后,定义一个具体实例的框架:
1 2 3 4 5 6 7 8
框架名: 【张三的车】 ISA: 【轿车】 品牌: 值: "Toyota" 型号: 值: "Camry" 发动机: 值: 【发动机-编号A123】 颜色: 值: "黑色" 购买时间: 值: 2022-03-15 里程数: 值: 15000 (fcn): 当里程数更新时,计算是否需要保养 -
被引用的框架:
1
2
3
4
框架名:    【发动机-编号A123】
ISA:       【V6发动机】
排量:      值: 3.5
马力:      值: 301
2.4. 对比与总结
与产生式表示法的对比:
| 特征 | 产生式表示法 | 框架表示法 |
|---|---|---|
| 基本单元 | 规则 (IF-THEN) | 框架 (对象-属性) |
| 知识类型 | 善于表示过程性知识和判断规则 | 善于表示陈述性知识和静态描述 |
| 组织方式 | 规则集合,相对扁平 | 层次化的框架网络 |
| 核心机制 | 匹配-触发 | 属性填充、继承 |
| 类比 | 一本操作手册(告诉你什么情况该做什么) | 一张信息登记表(告诉你一个东西由什么组成) |
总结:
| 特性 | 描述 | 优点 |
|---|---|---|
| 结构性 | 知识被组织成结构化的单元, 符合人类对事物的认知习惯。 |
表达能力强,能清晰地描述复杂对象。 |
| 继承性 | 通过AKO和ISA关系实现属性继承。 | 减少知识冗余,简化知识库的构建和维护。 |
| 自然性 | 用“对象-属性-值”的方式表示,非常直观。 | 易于理解和实现。 |
| 封装性 | 将描述一个对象的所有信息 封装在一个框架内。 |
模块化好,便于管理。 |
| 过程性知识结合 | 通过if-needed、if-added 等侧面附加过程(代码)。 |
知识表示灵活,具备动态计算和推理能力。 |
| 缺点 | 描述 |
|---|---|
| 缺乏形式化基础 | 不如逻辑表示法那样有严谨的数学基础,推理可能不严格。 |
| 构建成本高 | 构建一个高质量的框架网络需要大量的领域知识和设计工作。 |
| 效率问题 | 在继承链很长时,查找效率可能会降低。 |
在实际的专家系统中,这两种方法常常结合使用:
- 用框架来表示系统诊断/配置的对象(例如:患者、汽车、计算机组件)。
- 用产生式规则来表示关于这些对象的专家经验和推理知识(例如:IF 汽车无法启动 AND 启动机无声 THEN 检查蓄电池)。规则的前提和结论都可以操作框架中的槽。
3. 基于RDF的表示与推理
3.1. 语义网
随着互联网的发展,各种资源(如:文件、图片、视频、网页、数据库、API)都开始被互联网所使用。但是,万维网(World Wide Web)上的信息本质上是为人类设计的:HTML 标签(如 <h1>、<p>、<a>)只规定了信息“如何展示”,却不描述“是什么”。对机器而言,“北京是中国的首都”与“水是无色的”一样,都只是网页中的一段文本——搜索引擎可以索引这些词汇,却无法理解其中的语义,也就无法自动完成“找出所有国家的首都并按人口排序”这类推理任务。
1998 年,万维网发明人 Tim Berners-Lee 提出 语义网(Semantic Web) 愿景:对万维网进行扩展,使 Web 上的信息不仅可供人类阅读,还能以机器可理解、可处理的方式描述其语义,让计算机能够自动地发现、整合与推理信息。其核心思想是,通过给万维网上的文档 (如:HTML文档、XML文档)添加能够被计算机所理解的语义「元数据」(meta data),从而使整个互联网成为一个通用的信息交换媒介。
Tim Berners-Lee 在 2006 年普林斯顿大学演讲和后期接受媒体采访时公开表示,他最初将这种智能网络命名为语义网或许不够贴切,也许更准确的名称应该是数据网(Data Web)。
语义网并非一个单一技术,而是一组 W3C 标准构成的分层技术栈,每一层都建立在前一层之上。W3C 组织是语义网主要的推动者和标准制定者:
flowchart LR
    A["URI / IRI<br/>全局资源标识"] --> B["XML<br/>统一语法与交换格式"]
    B --> C["RDF<br/>三元组描述资源关系"]
    C --> D["RDFS / OWL<br/>定义类、属性与约束"]
    D --> E["逻辑与推理<br/>演绎推理 / 规则"]
    E --> F["信任<br/>证明与数字签名"]
其中,各层职责如下:
- URI/IRI 层:为每个资源赋予全局唯一的标识;
- XML 层:提供统一、可交换的语法格式,RDF/XML 序列化即基于此层;
- RDF 层:以(主语,谓语,宾语)三元组描述资源及其关系,构成数据的语义骨架;
- 本体层(RDFS / OWL):在 RDF 之上定义类、属性、层次与约束,赋予数据领域语义;
- 逻辑与推理层:基于 RDF/本体进行演绎推理,从显式知识推导隐式知识,其逻辑基础正是符号逻辑;
- 信任层:通过证明与数字签名保证语义网信息的可信性,属于愿景中的理想顶层。
语义网提供的是一整套“如何让机器理解信息语义”的标准与愿景;而知识图谱,则是这一愿景在大规模真实世界数据上的工程化实现。当这些技术被用于大规模地描述真实世界中的实体及其关系时,便催生了知识图谱。
3.2. RDF
3.2.1. 基本概念
RDF(Resource Description Framework,资源描述框架)是一种用于表示信息的标准模型,主要用于描述 网络资源 的语义信息。RDF是万维网联盟定义的标准,用于描述网络资源。其核心思想非常简单却非常强大:
用 “主语-谓语-宾语” 的形式,将世界描述为一个个相互连接的陈述。
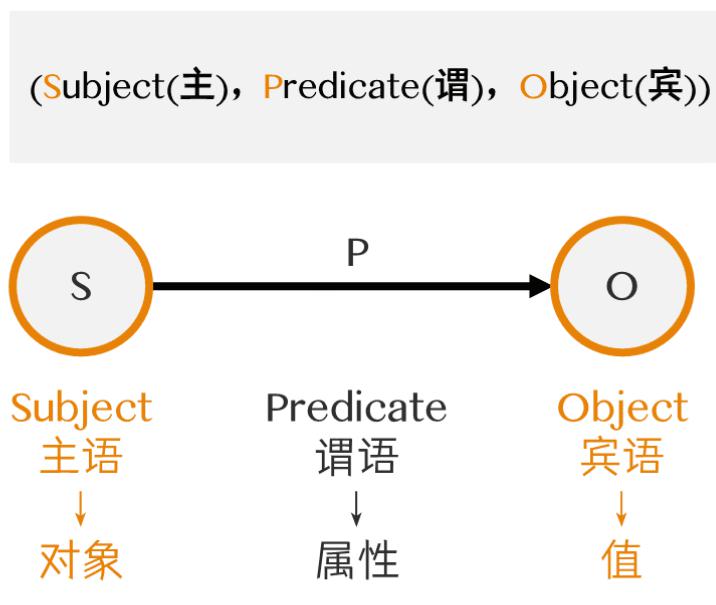
上述三元组中:
-
主语(Subject):你要描述的资源(事物)。例如:http://example.org/Alice
-
谓语(Predicate):资源的某个属性或它与另一个资源的关系。例如:http://schema.org/knows
-
宾语(Object):属性的值。这个值可以是一个文字(如字符串、数字),例如:”三体”;也可以是另一个资源,例如:http://example.org/Bob
上述三元组表达了一个事实:Alice 认识 Bob(或了解《三体》这本书)。
从 RDF 的名称我们不难看出,它是一个描述框架,任何满足其框架规定的描述都可以成为 RDF 描述。为了将 RDF 的描述具体化,我们定义如下:
- 资源(Resource):所有以 RDF 表示法来描述的东西都叫做资源,它可能是一个网站,可能是一个网页,可能只是网页中的某个部分,甚至是不存在于网络的东西,如纸本文献、器物、人等。在 RDF 中,资源是以统一资源标识(URI,Uniform Resource Indentifiers)来命名,其中:
- 统一资源定位器(URL,Uniform Resource Locators),
- 统一资源名称(URN,Uniform Resource Names),
- 都是 URI 的子集。
-
属性(Properties):属性是用来描述资源的特定特征或关系,每一个属性都有特定的意义,用来定义它的属性值(Value)和它所描述的资源形态,以及和其它属性的关系。
- 陈述(事实)(Statements):特定的资源以一个被命名的属性与相应的属性值来描述,称为一个RDF陈述,其中资源是主语,属性是谓语,属性值则是宾语,陈述的宾语除了可能是一个字符串,也可能是其它的资料形态或是一个资源。
注意,RDF 只是一种数据模型,只约定数据的结构,不关心任何数据的含义。
3.2.2. RDF 的序列化
序列化是指将数据结构保存为可读的格式,RDF 常用的序列化包括以下三种:
-
Turtle 语法:对于 RDF 来说,最常用的序列化格式是 Turtle,它也是人类可读性最好的格式,推荐在开发和调试中使用:
1
2
3
4
5
6
@prefix ex: <http://example.org/> .
@prefix schema: <http://schema.org/> .

ex:Alice a schema:Person ;
        schema:name "Alice" ;
        schema:knows ex:Bob .
-
RDF/XML:
1
2
3
4
5
6
<rdf:RDF xmlns:rdf="http://www.w3.org/1999/02/22-rdf-syntax-ns#"
         xmlns:foaf="http://xmlns.com/foaf/0.1/">
  <rdf:Description rdf:about="http://example.org/person/Alice">
    <foaf:name>Alice</foaf:name>
  </rdf:Description>
</rdf:RDF>
-
N-Triples:这是一种非常简单的RDF语法,每行表示一个三元组,使用空格分隔主体、谓语和宾语,并且需要用尖括号
< >括起来。即用多个三元组来表示RDF数据集。例如:1 2
<http://example.org/person/Alice> <http://xmlns.com/foaf/0.1/name> "Alice" . <http://example.org/person/JohnSmith> <http://xmlns.com/foaf/0.1/name> "John Smith" .
3.3. RDFS(RDF-Schema)
查看如下 RDF 资源:
1
2
3
4
5
6
7
8
9
# 定义一些实例(个体)
:Alice a :Person.
:Bob a :Person.
:TheGodfather a :Movie.

# 描述它们之间的关系
:Alice :likes :Bob.
:Alice :likes :TheGodfather.
:Bob :hasBirthdate "1990-01-01"^^xsd:date.
在这个层面上,我们只知道:
-
存在一个叫 Alice 的东西,它被归类为 Person。
-
存在一个叫 Bob 的东西,它也被归类为 Person。
-
存在一个叫 TheGodfather 的东西,它被归类为 Movie。
-
Alice “喜欢” Bob。
-
Alice “喜欢” TheGodfather。
-
Bob 有一个生日是 “1990-01-01”。
但机器不知道:
-
Person 和 Movie 到底是什么?它们有什么关系?
-
likes 这个属性是什么意思?它可以用来连接什么类型的东西?
-
hasBirthdate 这个属性的值应该是什么格式?它能被用于 Movie 吗?
也就是说 RDF 只关心陈述事实,但不关心这些事实的含义。
在此基础上,人们提出了 RDF-Schema(RDFS),通过引入了一组标准的词汇(本身也是一个 RDF 词汇表),用来定义我们使用的术语(类别、属性),它为数据赋予了语义,因此 RDFS 是一个本体语言。
常用的词汇表示包括:
1
Class, subClassOf, Property, subPropertyOf, Domain, Range, type
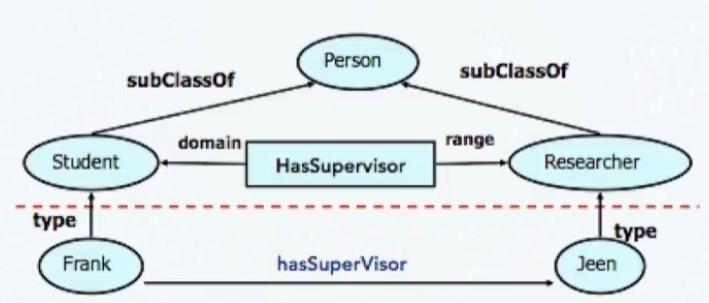
基于 RDFS 我们就可以进行简单的推理:
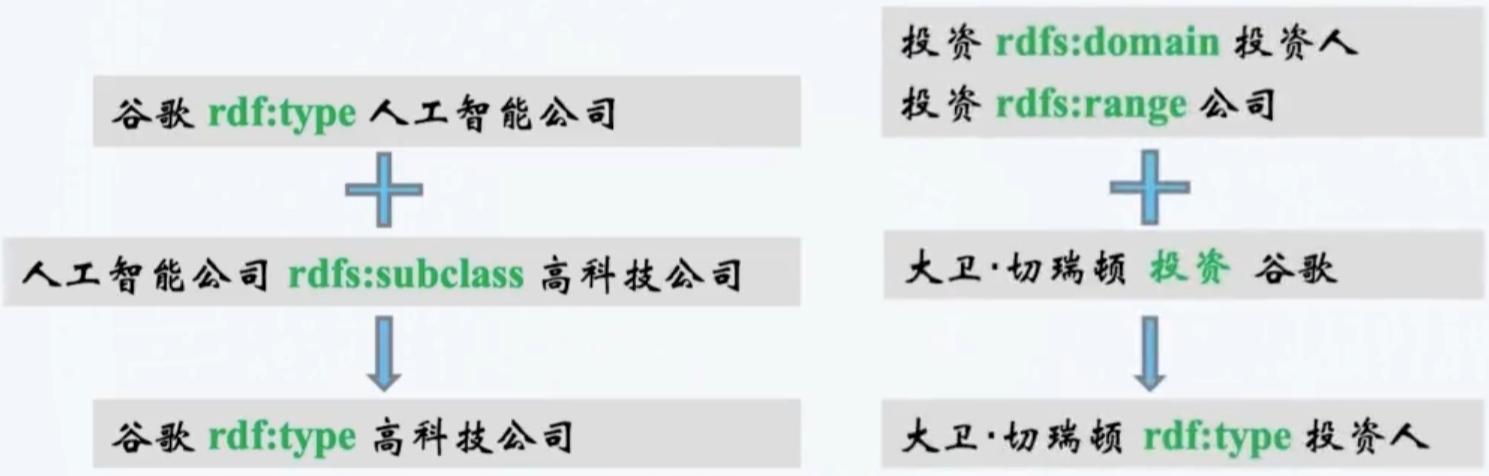
更加复杂的情况下,我们基于前面提出的 RDF 资源,使用如下词汇进行定义:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
# 首先定义一些类(Class)
:Person a rdfs:Class.
:Movie a rdfs:Class.
:CreativeWork a rdfs:Class.

# 声明类之间的层次关系(Movie 是 CreativeWork 的子类)
:Movie rdfs:subClassOf :CreativeWork.

# 定义一些属性(Property)
:likes a rdf:Property.
:hasBirthdate a rdf:Property.

# 声明属性的约束
# :likes 属性的主体(domain)可以是任何资源(范围很广)
:likes rdfs:domain :Resource.

# :likes 属性的客体(range)也可以是任何资源
:likes rdfs:range :Resource.

# :hasBirthdate 属性的主体(domain)必须是 Person
:hasBirthdate rdfs:domain :Person.

# :hasBirthdate 属性的客体(range)必须是日期值
:hasBirthdate rdfs:range xsd:date.
可以推理出:
-
从
rdfs:subClassOf推理:-
已知:
:Movie rdfs:subClassOf :CreativeWork.和:TheGodfather a :Movie. -
推理出:
:TheGodfather a :CreativeWork.(因为电影是创意作品的子类)
-
-
从
rdfs:domain推理:-
已知:
:hasBirthdate rdfs:domain :Person.和:Bob :hasBirthdate "1990-01-01". -
推理出:
:Bob a :Person.(这个推理在我们的例子中已经是显式声明的,但如果没声明,机器可以推出来) -
重要: 如果有人错误地写了一个三元组
:TheGodfather :hasBirthdate "1972-01-01",推理机可以根据rdfs:domain :Person推断出:TheGodfather a :Person,这显然是一个矛盾,可以帮助发现数据错误。
-
-
从
rdfs:range推理:-
已知:
:hasBirthdate rdfs:range xsd:date. -
当看到
:Bob :hasBirthdate "1990-01-01"时,机器就知道"1990-01-01"应该被当作一个日期对象来处理,而不是一个普通的字符串。
-
RDFS 相比 RDF 已经可以做简单推理了,但仍有许多局限,如无法表达以下情形:
- 类的等价、互斥
- 属性的约束:属性是唯一的(函数属性,身份证号唯一对应一个人)、属性的逆、属性的传递
- 基数约束:一个人有且仅有 1 个生日;一本书至少 1 个作者
- 并集、交集、补集等复杂集合定义
归根结底,RDFS 是弱语义,很多现实本体需求满足不了。W3C 需要更强的本体语言,于是启动 OWL。
3.4. OWL
3.4.1. 基本概念
OWL(Web Ontology Language)是建立在 RDF/RDFS 之上的一种用于表示和共享本体(Ontology)的标准化语言。OWL 旨在使计算机能够更好地理解和处理信息,从而支持语义搜索、知识图谱构建、自动推理和智能应用的开发。
本体是一种形式化的知识表示,用于描述领域中的概念、实体和它们之间的关系。
Ontology in Philosophy: Ontology is the philosophical study of the nature of being, becoming, existence or reality, as well as the basic categories of being and their relations.
—Merriam-Webster
Ontology in Computer Science and Artificial Intelligence: An ontology is a description (like a formal specification of a program) of the conceptsand relationships that can formally exist for an agent or a community of agents.
—Tom Gruber, Founder of Siri
Web Ontologies: Ontologies based on web standards such as RDFS/OWL. OWL is based on Description Logica very very long history of research in Artificial Intelligence.
在 RDFS 的基础上,人们希望能够构建出一种更加强大的新的本体语言,比如希望能够进行如下推理:
- 分类:使用类成员关系的条件来推推导类自身之间的关系。
- 等价关系和相同性。
- 不相交关系和不同性。
- 类的二元组合:有时需要类以超出子类关系的方式组合,如定义 :Person 是两个不相交的类 :Female 和 :Male 的并集。
- 属性的局部作用域:区别不同情景中的值域限制。
- 属性的特定:如声明一个属性是传递的或者互逆的。
- 基础限制:对一个属性可能或者必须拥有的不同取值的数目施加限制。
- 一致性:确定定义之间的冲突。
因此提出了 OWL。我们也可以把 OWL 当做是 RDFS 的一个扩展,其添加了额外的预定义词汇:
- RDF-Schema
- Class
- subclass
- Property
- subProperty
- …
- OWL
- Complex Class(复杂类)
- intersection → 交(逻辑与)
- union → 并(逻辑或)
- complement → 补(逻辑非)
- Property Restrictions(属性限制)
- existential quantification → 存在量化 $\exists$
- universal quantification → 全称量化 $\forall$
- has Value → 值约束
- Property Characteristics(属性特性)
- inverseOf → 逆属性
- SymmetricProperty → 对称属性
- FunctionalProperty → 函数型属性
- Complex Class(复杂类)
flowchart LR
    A[RDF] --"规则:Class, Property,..."--> B["RDF-Schema<br/>(RDFS)"]

    B -- "更复杂规则+关系:ComplexClass,..." --> C[OWL]
基于上述额外的预定义词汇,下面介绍几种典型的 OWL 表达构建:
-
等价性声明
exp:运动员 owl:equivalentClass exp:体育选手 exp:获得 owl:equivalentProperty exp:取得 exp:李明 owl:sameAs exp:小明 -
声明属性的传递性
exp:ancestor rdf:type owl:TransitiveProperty exp:小明 exp:ancestor exp:小林 exp:小林 exp:ancestor exp:小志 ==> exp:小明 exp:ancestor exp:小志. -
声明两个属性互反
exp:ancestor owl:inverseOf exp:descendant exp:小明 exp:ancestor exp:小林 ==> exp:小林 exp:descendant exp:小明. -
声明属性的函数型
exp:hasMother rdf:type owl:FunctionalPropertyexp:hasMother是一个具有函数性的属性,因为每个人只有一个母亲,作为约束作用到知识库 -
声明属性的对称性
exp:friend rdf:type owl:SymmetricProperty exp:小明 exp:friend exp:小林 ==> exp:小林 exp:friend exp:小明 -
声明属性的局部约束:存在限定
exp:SemanticWebPaper owl:onProperty exp:publishedIn ; owl:someValuesFrom exp:CCF-A .exp:publishedIn在主语属于exp:SemanticWebPaper类的时候,宾语的取值部分来自exp:CCF-A这个类。上述描述相当于「关于语义网的论文(SemanticWebPaper的实例)发表在CCF-A类(会议/期刊)上」。
3.4.2. 语法表示
除了可以采用 RDF/XML 语法表示(OWL/XML)和 Turtle 表示外,OWL(OWL 2)还提供了 Manchester 语法,这是基于 RDF 的一种表示方式:
Class: Person
    EquivalentTo: Man or Woman
Mancnester 语法是诸如 Protégé 在内的当前绝大多数本体编辑器在用户界面中使用的语法。
3.4.3. 子语言
OWL 包含一系列语言家族(子语言),每一种子语言都是前述语义表达构件的一类集合,并有相应的复杂度分析。如图,
- OWL Full:使用所有的 OWL 原语,在结构上和语义上完全兼容 RDF,缺点是这个语言已经变得太强以至于是不可判定的,使得任何完备(或高效)推理支持的希望都破灭了。
- OWL DL:被映射到描述逻辑(DL)上,描述逻辑是谓词逻辑的一个子集,它使得高效推理成为可能。它限制了 OWL2、RDF 和 RDFS 的原语使用方式,这些限制保证该语言维护了与一个广泛理解的描述逻辑之间的直接对应。 OWL2 DL 可以利用大量现有的推理机,例如 Pellet、FaCT、RACER 和 HermiT。缺点是失去了和 RDF 间的完整的兼容性。这是目前最常用的 OWL 子语言。
- OWL Lite:轻量版,类层次、简单基数(只能 0/1),推理最快;用于简单本体
3.5. OWL 2
3.5.1. 基本概念
OWL 标准 2004 发布之后,社区大量使用,发现很多常用建模需求缺失,典型需求包括:
- OWL Lite/DL/Full 划分不方便工程落地;
- 缺少对数据类型、属性链、限定基数等实用特性;
- 不同场景推理性能差异巨大,缺少专门针对大数据、规则推理的子集规范。
于是 W3C 启动 OWL2 修订,主要新增如下能力:
- Cardinality Restrictions(基数约束)
- 用于定义基于属性值数量限制的类
- maxQualifiedCardinality → 最大基数限定(至多)
- minQualifiedCardinality → 最小基数限定(至少)
- qualifiedCardinality → 精确基数限定
- Property Characteristics(属性特性)
- inverseOf → 逆属性
- SymmetricProperty → 对称属性
- AsymmetricProperty → 非对称属性
- propertyDisjointWith → 属性互斥
- ReflexiveProperty → 自反属性
- FunctionalProperty → 函数型属性
- Property Chains → 属性链
其中:
- 属性链(property chain):
hasMother o hasMother ⊑ hasGrandmother母亲的母亲是祖母 - 限定基数(qualified cardinality):至少 2 个男性孩子
其他一些特性包括:
- 自约束属性(hasSelf)
- 丰富的数据类型支持(数值、字符串比较)
- 匿名个体、实体注解增强
因此,OWL2可以实现更加丰富的定义,如:
-
声明属性的局部约束:基数限定
exp:Person rdfs:subClassOf [ a owl:Restriction ; owl:onProperty exp:hasMother ; owl:cardinality "1"^^xsd:integer ] .exp:hasMother在主语属于exp:Person类的时候,宾语的取值只能有一个(每个人只有一个母亲);”1” 的数据类型被声明为xsd:integer。这是基数约束(Cardinality Restriction),本质上属于属性的局部约束,表示Person是「hasMother取值恰好为 1」这类实例的子类。 -
声明相交的类
exp:Mother owl:intersectionOf _tmp _tmp rdf:type rdfs:Collection _tmp rdfs:member exp:Person _tmp rdfs:member exp:HasChildren_tmp是临时资源,它是rdfs:Collection类型,是一个容器;它的两个成员是exp:Person、exp:HasChildren。上述三元组说明exp:Mother是exp:Person、exp:HasChildren这两个类的交集。
此外,最重要的改动为废弃 OWL Lite/DL/Full,换成 4 个 OWL2 Profile(剖面),如下图所示:
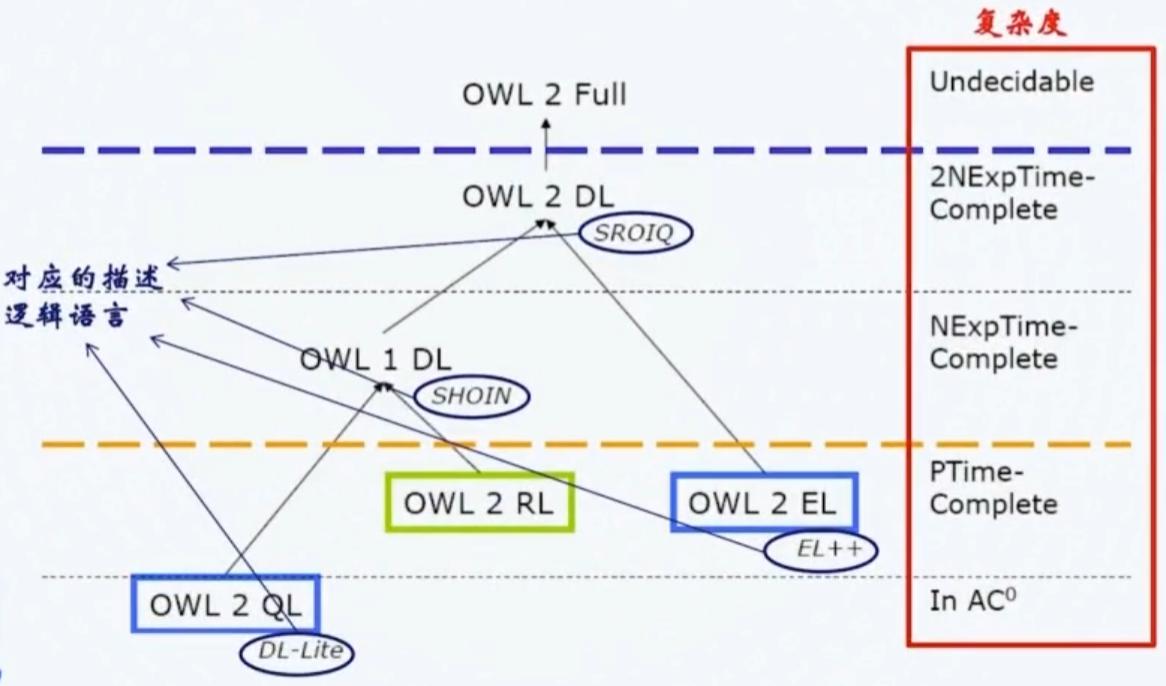
剖面的概念是 OWL2 的可判定子集,面向不同工程场景,控制表达能力换取推理效率。四种剖面如下:
- OWL 2 QL:Query Language,它只包含基本的语义表达,如类、属性、数据类型等,面向数据库查询,本体映射关系数据库,把本体查询翻译成 SQL。轻量,适合数据访问;
- OWL 2 RL:Rule Language,在扩展 RDFS 表达的同时,保持了较低的复杂度,可以转化为规则引擎(如 Datalog),适合大数据、RDF 三元组库推理,性能好。很多图数据库语义推理用 RL;
- OWL 2 EL:Existential Logic,适合大本体(医疗本体 SNOMED-CT),大量类层次、存在约束;推理多项式时间,适合百万级类,常用于生物医疗领域;
- OWL 2 DL:完整描述逻辑子集,表达能力最强(除 Full 以外),推理复杂度是 N2EXPTIME(双指数),适合中小本体。
OWL2 Full 仍然保留:完整兼容 RDF,不可判定,学术研究为主。
3.5.2. OWL 2 DL 推理
OWL2 DL 基于 SROIQ (D) 描述逻辑语言,其是精心裁剪出来的「一阶谓词逻辑子集」,限制了量词只能出现在特定形式(∃R.C, ∀R.C),禁止任意嵌套的一阶公式,从而获得可判定性。
根据前文我们知道,一阶逻辑可以使用归结原理进行自动推理,但 OWL2 DL 推理器底层不使用通用一阶归结,而是使用「表演算」(Tableau),其专门针对 DL 语法结构做优化。现在工业主流 OWL2 DL 推理器(HermiT, FaCT++)全部基于 Tableau。
Tableau 算法的核心思想是反证法(归谬法),DL 所有标准推理任务,都可以归约到「概念可满足性问题」,因此所有 OWL DL 推理任务都可以转化为可满足性检查。Tableau 会不断展开概念断言、生成新个体 / 角色边,遇到分支回溯;发现矛盾(clash)证明不可满足。由于 SROIQ (D) 对角色(传递、逆、属性链、基数)的扩展极大增加 Tableau 实现复杂度,带来双指数复杂度,所以只能用于小规模本体实例。
具体的推理过程基于描述逻辑(Description Logic)的两个概念:
- TBox(Terminology Box,术语盒),用于描述模式 / 本体(概念、类、关系公理)的集合
- ABox(Assertion Box,断言盒),用于描述实例数据(关于个体的事实)的集合
TBox 中常见的公理类型有:
- 子类包含:$C \sqsubseteq D$,C 是 D 的子类。例:$Person \sqsubseteq Animal$
- 类等价:$C \equiv D$。例:$Human \equiv Person$
- 类不相交:$C \sqsubseteq \neg D$。例:$Male \sqsubseteq \neg Female$
- 属性公理(角色公理)
- 属性子属性:$R \sqsubseteq S$
- 逆属性:$R \equiv R^-$
- 传递、对称、非自反等角色特征
- 属性链:$R_1 \circ R_2 \sqsubseteq R_3$
- 类定义(带约束的复杂类)
- 存在约束:$Person \sqsubseteq \exists hasParent.Person$(每个人都有父母,是人)
- 全称约束:$DogOwner \sqsubseteq \forall hasPet.Dog$(养狗的人所有宠物都是狗)
- 限定基数:$PersonWithTwoKids \equiv (=2\ hasChild.Person)$(恰好 2 个孩子的人)
推理器对 TBox 做的推理包括:
- 类可满足性:这个类有没有可能存在实例?如果$C \sqsubseteq \neg C$,说明 C 不可能有实例(矛盾类)
- 本体分类 / 层次计算:自动计算所有类的完整子类层次,把隐含的父子关系补全
- TBox 一致性:整套术语本身有没有矛盾(不需要任何实例)
以下是一个典型的 TBox(Turtle 语法):
1
2
3
4
5
6
:Person a owl:Class .
:Male a owl:Class ; rdfs:subClassOf :Person ; owl:disjointWith :Female .
:Female a owl:Class ; rdfs:subClassOf :Person .
:hasMother a owl:ObjectProperty ; rdfs:range :Female .
:hasGrandmother a owl:ObjectProperty ;
    owl:propertyChainAxiom ( :hasMother :hasMother ) .
ABox 是关于个体(实例)的断言集合,描述具体实体属于哪个类、实体之间有什么关系。ABox 里面只出现个体,引用 TBox 定义好的类和属性。ABox 包含两种基本断言:
- 概念断言(类型断言):$a:C$,个体a属于类C。例:$张三:Person$
- 角色断言(关系断言):$(a,b):R$,个体 $a$ 和 $b$ 有属性 $R$。例:$(张三,李母):hasMother$
在具体推理时,推理器会同时加载 TBox 和 ABox,基于 TBox 的公理,对 ABox 实例做推导:
沿用上面例子:
- TBox 公理:
hasMother ∘ hasMother ⊑ hasGrandmother - ABox 事实:
ZhangSan hasMother LiMu,LiMu hasMother WangPo👉 联合推理得到新的 ABox 断言:ZhangSan hasGrandmother WangPo
冲突例子:
TBox:Male 和 Female 不相交。
ABox:ZhangWei a :Male , :Female
👉 TBox+ABox 不一致,推理器抛出矛盾。
3.6. 知识图谱
3.6.1. 基本概念
知识图谱(Knowledge Graph)是 2012 年谷歌提出的一种知识库系统。其并不强制使用语义网结构(RDF/RDFS/OWL),其更普遍使用属性图结构(节点—边—节点「属性」)来组织、描述和存储实体及其相互关系的语义网,其中:
- 节点(实体):真实世界中的具体或抽象对象,如 “北京”“张三”“人工智能”;
- 边(关系):实体之间的语义联系,如 “首都”“出生于”“研究领域”;
- 属性:实体的特征描述,如 “北京的人口为 2185 万”。
形式上,知识图谱中的每一条知识都可以看作一个(主语,谓语,宾语)三元组(Triple),这与 RDF 的核心思想完全一致——知识图谱正是 RDF 语义描述思想在大规模数据上的工程化实现。
一个小型示例:
graph LR
    BJ["北京"] -- "首都" --> CN["中国"]
    BJ -- "人口" --> P["2185 万"]
    ZS["张三"] -- "出生于" --> BJ
    ZS -- "工作于" --> BD["字节跳动"]
    BD -- "总部位于" --> BJ
知识图谱的概念并非凭空出现,而是语义网研究长期积累的产物。
- 2001 年,Tim Berners-Lee 等人在《科学美国人》上提出语义网(Semantic Web)愿景:让 Web 上的信息具有机器可理解的语义;
- 2007 年前后,链接数据(Linked Data)运动推动了开放知识库的建设,代表性项目包括从维基百科自动抽取的 DBpedia、众包协作的 Freebase(其数据后迁移至 Wikidata)等;
- 2012 年,Google 正式提出 Knowledge Graph 一词,并将其应用于搜索引擎,通过知识卡片(Knowledge Panel)直接向用户展示实体及其关联信息,“知识图谱”由此成为业界通用术语;
- 此后,Wikidata(2012 年启动,维基百科的支撑性知识库)、YAGO、Schema.org(面向网页标注的共享词汇表)等不断发展,知识图谱进入大规模工业应用阶段。
3.6.2. 知识图谱的体系架构
知识图谱作为一个完整系统,通常分为以下层次:
flowchart TB
    subgraph app[应用层]
        A1[语义搜索] --- A2[智能问答] --- A3[推荐系统] --- A4[行业应用]
    end
    subgraph store[知识存储层]
        B1[(图数据库)] --- B2[(RDF 三元组库)]
    end
    subgraph process[知识加工层]
        C1[质量评估] --- C2[推理补全] --- C3[知识更新]
    end
    subgraph fusion[知识融合层]
        D1[实体对齐] --- D2[共指消解] --- D3[冲突消解]
    end
    subgraph extract[知识抽取层]
        E1[实体识别] --- E2[关系抽取] --- E3[属性抽取]
    end
    subgraph represent[知识表示层]
        F1[本体建模<br/>RDF / RDFS / OWL]
    end
    F1 --> E1
    E1 --> D1
    D1 --> C1
    C1 --> B1
    B1 --> A1
其中
- 知识表示层:定义知识图谱的“骨架”,即本体(Ontology)。该层复用前面介绍的 RDF、RDFS、OWL 语言,明确领域内的类(Class)、属性(Property)及约束规则,是知识图谱区别于一般图数据的根本特征;
- 知识抽取层:从结构化数据、文本、网页等异构数据源中抽取实体、关系与属性;
- 知识融合层:解决多源数据中同一实体的指代不一问题(如 “北京” 与 “北京市”),保证图谱的一致性;
- 知识加工层:对图谱进行质量评估、推理补全与更新迭代,其中推理方法将在后面展开;
- 知识存储层:将图谱持久化到图数据库或 RDF 三元组库,支撑高效查询;
- 应用层:基于图谱对外提供搜索、问答、推荐等服务。
在逻辑上,知识图谱常被区分为两个层面(这一区分源自描述逻辑,也与一阶谓词逻辑中的“语法—语义”的划分相呼应):
- 模式层(TBox):描述概念与概念间的关系(如 “教师 $\subseteq$ 人”“课程 $\subseteq$ 教学内容”),对应本体的“语法”;
- 实例层(ABox):描述具体个体及其断言(如 “张三是教师”),对应本体的“语义/模型”。
3.6.3. 知识图谱的构建流程
知识图谱的构建是一个“数据进、知识出”的流水线,典型流程如下:
flowchart LR
    A[本体设计<br/>类 / 属性 / 约束] --> B[知识抽取<br/>实体 / 关系 / 属性]
    B --> C[知识融合<br/>实体对齐 / 共指消解]
    C --> D[知识加工<br/>质量评估 / 推理补全]
    D --> E[知识存储<br/>图数据库 / 三元组库]
    E --> F[知识应用<br/>搜索 / 问答 / 推荐]
    F -.->|反馈更新| A
- 本体设计:依据领域知识,用 RDFS/OWL 定义类、属性、层次关系与约束,这是构建的起点;
- 知识抽取:
- 命名实体识别(NER):从非结构化文本中识别出人名、地名、机构名等实体;
- 关系抽取:识别实体间的语义关系(如 “出生地”“任职于”);
- 属性抽取:抽取实体的属性值(如人物的出生日期);
- 知识融合:
- 实体对齐:判断不同来源的实体是否指向真实世界的同一对象(如 “北大” 与 “北京大学”);
- 共指消解:将文本中的代词、简称归并到同一实体;
- 冲突消解:处理多源数据不一致(如出生日期不同),可借助 2.2.4 节 OWL 的约束与一致性检查;
- 知识加工:进行质量评估(正确性、完整性、时效性),并利用 2.3.5 节的方法推理补全缺失知识;
- 知识存储与迭代:将结果入库,并随数据更新持续迭代。
3.6.4. 知识图谱的存储与查询
知识图谱的存储方案主要有两类:
- RDF 三元组库(Triple Store):与 RDF 模型天然契合,代表系统有 Apache Jena、Virtuoso、GraphDB 等,使用 W3C 标准的 SPARQL 查询语言;
-
SPARQL 查询示例(查询中国的首都):
1
2
3
4
5
6
PREFIX dbr: <http://dbpedia.org/resource/>
PREFIX dbo: <http://dbpedia.org/ontology/>
SELECT ?capital
WHERE {
  dbr:China dbo:capital ?capital .
}
-
该查询本质上是在 RDF 三元组集合上做模式匹配——找出所有满足「主语 = 中国、谓语 = 首都」的三元组,并将其宾语绑定到变量
?capital。这与一阶谓词逻辑中的“论域”的思想一脉相承:变量?capital的取值范围即为其“论域”。
-
-
属性图数据库(Property Graph):以“节点—边—属性”建模,查询效率高、表达灵活,代表系统有 Neo4j、JanusGraph 等,使用 Cypher 等图查询语言。
-
Cypher 查询示例(属性图):
1
2
MATCH (p:Person {name: "张三"})-[:出生于]->(c:City {name: "北京"})
RETURN p, c
-
3.6.5. 知识图谱中的推理
知识图谱中的推理(Knowledge Graph Reasoning)旨在从显式知识推导出隐式知识,主要包括三类方法:
- 基于本体的推理:利用 RDFS/OWL 定义的语义约束进行演绎推理,如:
- 子类传递:
电影 rdfs:subClassOf 创意作品,且《教父》 a 电影,可推出《教父》 a 创意作品; - 属性域/值域约束推理:见 3.3 节的例子;
- OWL 属性链、传递性、对称性等推理。
- 子类传递:
- 基于规则的推理:以产生式规则为原型,在知识图谱上定义逻辑规则(如 SWRL),例如:
1
IF 甲 出生于 某城市 AND 该城市 属于 某国 THEN 甲 是 该国公民
这与产生式系统的前向/后向推理机制一致。
- 基于图结构与嵌入的推理:利用图谱的拓扑结构(路径、连通性、图算法)进行推断;更进一步,可将图谱嵌入到低维向量空间(即后文的知识图谱嵌入,如 TransE),通过向量计算完成链接预测(Link Prediction)——预测缺失的边(如 “(张三,工作于,?)”),这既是知识补全的重要手段,也是知识表示从符号走向连续化的桥梁。
但需要注意,由于知识图谱更多的应用场景是互联网和工业界,其对推理的需求不大,因此更多采用属性图结构来构建知识图谱,也没有严格的 TBox/ABox 划分,Schema 通常是弱类型,所以甚至不进行推理。
3.6.6. 知识图谱的应用
- 语义搜索:Google、必应等搜索引擎基于知识图谱返回结构化知识卡片,而非仅返回网页链接;
- 智能问答(KBQA):将自然语言问题转化为图谱查询(如 “中国的首都是哪里?” → SPARQL 查询);
- 推荐系统:利用实体间的关联(如 “看过 A 的用户也看过与 A 同一导演的作品”)提升推荐的多样性与可解释性;
- 行业应用:
- 医疗:药物—靶点—疾病关系图谱辅助药物研发与临床决策;
- 金融:企业关联图谱用于风控、反欺诈与尽职调查;
- 电商:商品—品牌—类目图谱支撑导购与供应链管理;
- 社交:人物关系图谱支撑好友推荐与社群发现。
从符号逻辑,到 RDF/本体,再到本节的知识图谱,知识的表示形式日趋工程化、规模化,但本质上仍是“符号主义”路线——知识以离散符号(三元组)存储,机器难以直接理解其语义。这一局限正是后文“基于嵌入的表示”要解决的问题:知识图谱嵌入将符号三元组映射为连续向量,从而把符号知识转化为可计算、可学习的数值表示。
3.7. 小结
flowchart TD
    %% ================= 主干:逻辑与推理 =================
    subgraph CORE[逻辑与推理主干]
        direction TB
        FOL[一阶谓词逻辑<br/>FOL]
        DL[描述逻辑<br/>Description Logic]
        SROIQ[SROIQ-D<br/>OWL 2 DL 对应逻辑]
        TABLEAU[Tableau 算法]
        REASON[推理机<br/>Reasoner]
    end

    %% ================= 左侧:本体构件与知识图谱 =================
    subgraph LEFT[本体构件与知识图谱]
        direction TB
        TBOX[TBox<br/>术语公理]
        ABOX[ABox<br/>断言事实]
        KG[知识图谱]
        SEMWEB[语义网结构<br/>RDF 三元组 / 图]
        PROPG[属性图结构<br/>Property Graph]
    end

    %% ================= 右侧:RDF 语义栈 =================
    subgraph RIGHT[RDF 语义栈]
        direction TB
        RDF[RDF<br/>资源描述框架]
        RDFS[RDFS<br/>RDF Schema]
        OWL[OWL<br/>Web 本体语言]
        OWL2[OWL 2]
        EL[EL 剖面]
        QL[QL 剖面]
        RL[RL 剖面]
    end

    %% ================= 主干关系 =================
    FOL -->|形式化基础| DL
    DL -->|可表达为| SROIQ
    SROIQ -->|推理基础| TABLEAU
    TABLEAU -->|实现算法| REASON

    %% ================= 右侧语义栈关系 =================
    RDF -->|扩展| RDFS
    RDFS -->|扩展| OWL
    OWL -->|版本演进| OWL2
    OWL2 -->|DL 对应| SROIQ
    OWL2 -->|剖面| EL
    OWL2 -->|剖面| QL
    OWL2 -->|剖面| RL

    %% ================= 左侧构件关系 =================
    TBOX -->|术语层| OWL2
    ABOX -->|断言层| OWL2
    TBOX -->|输入| REASON
    ABOX -->|输入| REASON
    REASON -->|一致性检查| TBOX
    REASON -->|实例检查| ABOX

    %% ================= 知识图谱关系 =================
    RDF -->|数据模型| SEMWEB
    SEMWEB -->|一种表示| KG
    PROPG -->|另一种表示| KG
    OWL2 -->|本体增强| KG
    REASON -->|推理增强| KG
    TBOX -->|模式层| KG
    ABOX -->|数据层| KG

    %% ================= 样式 =================
    classDef logic fill:#e1f5fe,stroke:#01579b,stroke-width:2px
    classDef rdf fill:#fff3e0,stroke:#e65100,stroke-width:2px
    classDef owl fill:#f3e5f5,stroke:#4a148c,stroke-width:2px
    classDef reason fill:#e8f5e9,stroke:#1b5e20,stroke-width:2px
    classDef kg fill:#fce4ec,stroke:#880e4f,stroke-width:2px

    class FOL,DL logic
    class SROIQ,TABLEAU,REASON reason
    class RDF,RDFS rdf
    class OWL,OWL2,EL,QL,RL owl
    class TBOX,ABOX reason
    class KG,SEMWEB,PROPG kg
4. 基于嵌入的表示
4.1. 符号表示的局限
在前面的介绍中,知识通常以符号化的形式表示(符号主义)。例如 “北京是中国的首都” 这个事实,无论是用一阶逻辑、产生式规则、框架,还是用知识图谱中的 RDF 三元组来表示,本质都是离散符号的组合:
1
CapitalOf(Beijing, China)
或用RDF三元组
1
<北京, 是...的首都, 中国>
来表示。这种表示方式对人类很友好,精确且可解释,但存在「语义鸿沟」问题:计算机无法理解 “北京”、“中国”、“首都” 这些符号背后的实际含义。它只知道这是不同的符号。这导致了著名的 “中国房间” 思想实验所提出的问题。
中国房间思想实验:
想象一个完全不懂中文的人(比如一个只说英语的人)被关在一个房间里。房间里有一本巨大的规则书(用英文写的),以及很多中文符号。
输入:门外的人递进来一张纸,上面写着一些中文文字(比如一个问题)。房间里的人完全看不懂这些“天书”。
处理:这个人在规则书上查找这些 incoming 的中文字符。规则书完全基于符号的形状(语法)来操作。规则会说:“当你看到形状为‘X’的符号时,就在你的符号堆里找到形状为‘Y’的符号,然后把它递出去。”
输出:房间里的人按照规则书找到相应的中文符号,然后把它递出房间。
现在,假设那本规则书编写得极其完美(比如,它就像一个完美的聊天机器人程序或一个强大的AI模型)。从房间外的人(一个说中文的人)的视角来看,他们递进去一个中文问题,里面递出来一个非常合理、流畅的中文回答。
问题来了:房间外的人会认为房间里有一个完全理解中文的智能体(人或计算机)。但事实上,房间里的人完全不懂中文。他只是在机械地操作符号,对符号的含义一无所知。
这提醒我们,即使是最先进的大语言模型(如ChatGPT),它们的行为在表面上看起来智能无比,但其底层机制可能仍然是一种极其复杂的“查规则书”过程——基于海量数据学习到的统计规律来生成最可能的词序列,而非基于真正的理解、信念或欲望。简单来说,“中国房间”实验是一个强有力的提醒:即使某物行为上表现得完全像是有智慧的,也并不意味着它真的拥有内在的理解和意识。 这仍然是当今人工智能和哲学领域争论的焦点。
4.2. 基于独热编码的表示
作为从符号主义到连接主义的转换,基于嵌入的知识表示是连接主义的解决方案。它的核心思想是:将高维、稀疏的符号(如单词、实体、关系)映射到低维、稠密的连续向量空间(通常称为向量空间或嵌入空间)中。在这个空间里,每个点(一个向量)代表一个符号,而点与点之间的几何关系(如距离、角度)则反映了它们之间的语义关系。这里的 「嵌入」 就是一个低维、稠密的实数向量。
比如,在低维稠密空间中,“足球” 和 “篮球” 理应靠的比较近,因为在语义关系上二者都是球类。
符号的独热编码(one-hot encoding)是将符号映射为向量的一种方法。每个符号对应一个向量,向量的长度等于符号的数量。向量的每个元素都为 $0$,除了对应符号的元素为 $1$。假设给你一本英语词典,一共有 8752 个常用单次,那么用独热编码来表示一个单词,就是将单词映射到一个长度为 $8752$ 的向量,向量的每个元素都为 $0$,除了单词对应的元素为 $1$。那么可以有:
\[\begin{aligned} \text{abandon} &= [1, 0, 0, \cdots, 0, 0, 0,\cdots] \\ \text{school} &= [0, 0, 0, \cdots, 1, 0, 0,\cdots] \end{aligned}\]独热编码的缺点是:
- 稀疏性:独热编码的向量通常稀疏,因为大多数符号的向量元素都为 $0$。
- 长度固定:独热编码的向量的长度固定,不能适应不同长度的符号。
- 语义丢失:独热编码无法表示符号之间的语义关系。
- 训练困难:独热编码的向量无法进行训练,需要手动构造。
4.3. 基于嵌入的表示
嵌入向量(embedding vector)是将文本映射为向量的一种方法。嵌入向量的长度通常比独热编码的长度小,因为嵌入向量的每个元素都对应一个权重,而不是一个 $0$ 或 $1$。嵌入技术的理论基础是分布式假设:
1
“一个词是由其上下文决定的。” —— J. R. Firth, 1957
意思是,语义相近的词语,它们出现在文本中的上下文(周围的词)也应该是相似的。因此,通过建模上下文,我们可以为词语学习到能反映其语义的向量表示。
因此,问题就转化为:如何根据上下文获得嵌入向量? 这将在自然语言处理章节详细介绍。
5. 参考文献
[1] bilibili 知识图谱